Cours 5 · 2026–2027
Sujets supplémentaires
Annexes : d'où vient l'IA, comment on formalise et on évalue, et quelques compléments.
John Samuel · CPE Lyon
Intelligence artificielle et Deep Learning
Histoire · Formalisation · Classification · Hyperparamètres · Noyaux · R-CNN · Traduction
F₁ = 2 · p · r / (p + r)précision, rappel, et la moyenne harmonique qui les réconcilie
Fil rougeCe cours rassemble ce qui sert partout ailleurs : le vocabulaire (X, Y, f), les mesures (précision, rappel, F1) et le contexte historique.
notes
Intelligence artificielle et Deep Learning — Sujets supplémentaires
John Samuel, CPE Lyon · Année 2026-2027 · Courriel : john.samuel@cpe.fr
 Licence CC BY-SA 4.0.
A.1 · Histoire scientifique · [Pan 2016, Jaakkola 2019]
L'IA des années 2010 : acquisitions, chatbots, jeux, hôpitaux, recherche
Fusions et acquisitions
DNNresearch par Google en 2013 [1] : vision par ordinateur. LinkedIn par Microsoft en 2016 [2] : réseaux sociaux professionnels.
Les chatbots
Xiaobing : « comprendre » et répondre aux questions des utilisateurs en langage naturel.
Les programmes de jeux
AlphaGo par Google : victoire historique contre le champion du jeu de go Lee Sedol en 2016.
Les hôpitaux
Watson : une plateforme d'IA utilisée en santé pour aider les professionnels à analyser et interpréter des données médicales complexes.
Le langage naturel
Baidu : moteur de recherche.
MoteurLa méthode d'apprentissage profond est ce qui relie ces cinq exemples.
notes
- La méthode d'apprentissage profond. Les fusions et acquisitions d'entreprises : DNNresearch par Google en 2013 [1] (vision par ordinateur) ; LinkedIn par Microsoft en 2016 [2] (réseaux sociaux professionnels). Les chatbots : Xiaobing par Microsoft, « comprendre » et répondre aux questions des utilisateurs en langage naturel. Les programmes de jeux : AlphaGo par Google, victoire historique contre le champion du jeu de go Lee Sedol en 2016. L'utilisation dans les hôpitaux : Watson par IBM, une plateforme d'IA utilisée dans le domaine de la santé pour aider les professionnels à analyser et interpréter des données médicales complexes. La compréhension du langage naturel : Baidu, moteur de recherche.
A.1 · Histoire scientifique · [Pan 2016, Jaakkola 2019]
IA 1.0 : de la définition de 1956 aux hivers
La définition d'IA
La capacité des machines à comprendre, à penser et à apprendre d'une manière similaire à celle des êtres humains — proposée par J. McCarthy, M. L. Minsky, H. Simon, A. Newell, C. E. Shannon, N. Rochester…
Les années difficiles
1973 : le rapport de James Lighthill critique la recherche en IA au Royaume-Uni — ralentissement temporaire des financements publics, « l'effet Lighthill ». 1982–1992 : l'échec du développement d'un ordinateur intelligent par le Japon. 1984 : Cyc, base de connaissances informatisée capable de raisonner et de répondre à des questions complexes (Douglas Lenat, Stanford).
notes
- 1956 : la définition d'IA — la capacité des machines à comprendre, à penser et à apprendre d'une manière similaire à celle des êtres humains ; proposée par J. McCarthy, M. L. Minsky, H. Simon, A. Newell, C. E. Shannon, N. Rochester… 1970–2000 : 1973, le rapport de James Lighthill, critiquant la recherche en IA au Royaume-Uni, a conduit à un ralentissement temporaire des financements publics (« l'effet Lighthill ») ; 1982–1992, l'échec du développement d'un ordinateur intelligent par le Japon ; 1984, la construction manuelle d'une encyclopédie de la connaissance (Cyc) par Douglas Lenat à l'Université Stanford — un projet visant à créer une base de connaissances informatisée capable de raisonner et de répondre à des questions complexes.
A.1 · IA 2.0 · [Pan 2016, Jaakkola 2019]
IA 2.0 : Internet, capteurs, Big Data, et des demandes sociales
Ce qui a changé
Popularité de l'Internet · l'utilisation des capteurs · Big Data · l'e-commerce.
Ce que l'on attend de l'IA
Des villes intelligentes · médecine · transport · les automobiles sans conducteur · les smartphones.
notes
- 1990s–présent : popularité de l'Internet, l'utilisation des capteurs, Big Data, l'e-commerce. Des demandes sociales pour l'IA : des villes intelligentes, médecine, transport, les automobiles sans conducteur, les smartphones.
A.1 · IA 2.0 · [Pan 2016]
IA 2.0 : cinq technologies, et l'avenir vu de 2016
Cinq piliers
L'IA basée sur des données massives (Big Data) · l'intelligence de la foule sur Internet · le savoir médiatique croisé · l'intelligence hybride homme-machine · systèmes autonomes et intelligents.
Quatre directions
L'IA explicative et générique · la cognition, l'apprentissage et l'inférence trans-médiatiques · l'intelligence communautaire à partir de l'intelligence des foules basée sur l'intelligence individuelle · des systèmes autonomes et intelligents pour le développement de machines et de produits intelligents.
notes
- Les technologies à l'origine de l'IA 2.0 : l'IA basée sur des données massives (Big Data) ; l'intelligence de la foule sur Internet ; le savoir médiatique croisé ; l'intelligence hybride homme-machine ; systèmes autonomes et intelligents. L'avenir : l'IA explicative et générique ; la cognition, l'apprentissage et l'inférence trans-médiatiques ; l'intelligence communautaire à partir de l'intelligence des foules basée sur l'intelligence individuelle ; des systèmes autonomes et intelligents pour le développement de machines et de produits intelligents.
A.1 · IA 3.0
IA 3.0 : l'ère des modèles génératifs
notes
- 2012 : AlexNet [Krizhevsky 2012] remporte ImageNet ; l'apprentissage profond sur GPU s'impose en vision. 2017 : le Transformer [Vaswani 2017] remplace la récurrence par l'attention. 2018 : BERT et GPT-1, pré-entraînement sur de grands corpus, puis adaptation à la tâche (voir 4.7). 2020 : GPT-3 (175 milliards de paramètres) ; AlphaFold 2 (structure des protéines). 2022 : DALL·E 2, Stable Diffusion (images par diffusion) ; ChatGPT en novembre — ChatGPT fait entrer les grands modèles de langage dans l'usage grand public. 2023–2025 : modèles multimodaux, modèles à poids ouverts (Llama, Mistral), agents avec outils ; AI Act européen (2024). 2024 : prix Nobel de physique à Hopfield et Hinton (réseaux de neurones) ; de chimie à Baker, Hassabis et Jumper (AlphaFold).
A.2 · Introduction à l'apprentissage machine
Apprendre à partir de données plutôt que programmer explicitement
L'apprentissage machine (machine learning, ML) est un domaine de l'IA qui développe des techniques permettant aux ordinateurs d'apprendre à partir de données : prendre des décisions ou réaliser des tâches sans être explicitement programmés, en s'appuyant sur des modèles et des motifs appris.
Données d'entraînement
L'apprentissage machine commence par des données. Ces données d'entraînement enseignent au modèle les motifs et les relations qu'il doit identifier.
Modèles
Des représentations mathématiques qui capturent les relations entre les caractéristiques des données. Entraînés sur les données d'entraînement, ils généralisent pour prédire sur de nouvelles données non vues.
notes
- L'apprentissage machine, également connu sous le nom de machine learning (ML), est un domaine de l'intelligence artificielle (IA) qui se concentre sur le développement de techniques permettant aux ordinateurs d'apprendre à partir de données. L'objectif principal est de permettre aux systèmes informatiques de prendre des décisions ou de réaliser des tâches sans être explicitement programmés, en s'appuyant sur des modèles et des motifs appris à partir des données. Données d'entraînement : l'apprentissage machine commence par des données ; elles sont utilisées pour enseigner au modèle les modèles et les relations qu'il doit identifier. Modèles : représentations mathématiques qui capturent les relations entre les différentes caractéristiques des données ; entraînés à partir des données d'entraînement, capables de généraliser pour faire des prédictions sur de nouvelles données non vues.
A.2 · Introduction à l'apprentissage machine
Entraîner, puis valider et tester
Entraînement et apprentissage
Entraîner un modèle, c'est l'exposer aux données d'entraînement pour qu'il ajuste ses paramètres et minimise les erreurs de prédiction. L'apprentissage se produit lorsque le modèle améliore sa capacité à prédire avec précision.
Validation et test
Après l'entraînement, le modèle est évalué sur des données de validation et de test pour vérifier qu'il généralise aux données non vues. Cela évite le surajustement : apprendre trop spécifiquement les données d'entraînement sans pouvoir généraliser.
notes
- Entraînement et apprentissage : l'entraînement d'un modèle implique de l'exposer aux données d'entraînement, lui permettant d'ajuster ses paramètres pour minimiser les erreurs de prédiction ; l'apprentissage se produit lorsque le modèle améliore sa capacité à faire des prédictions précises. Validation et test : après l'entraînement, le modèle est évalué sur des données de validation et de test pour s'assurer qu'il généralise bien aux données non vues ; cela aide à éviter le surajustement, où le modèle apprend trop spécifiquement les données d'entraînement.
A.2.1 · Positionnement de l'apprentissage machine
L'apprentissage machine irrigue cinq domaines
Intelligence artificielle
Composante essentielle de l'IA : tirer des conclusions, apprendre à partir d'expériences passées et améliorer sa performance sans être explicitement programmé.
Informatique et technologie
Vision par ordinateur, reconnaissance vocale, traduction automatique, chatbots, et diverses applications qui exploitent la capacité des modèles à apprendre des données.
Santé
Prédiction de maladies, analyse d'images médicales, découverte de médicaments ; personnalisation des traitements et gestion des dossiers médicaux électroniques.
Finance
Détection de fraudes, prévision des marchés, analyse de crédit, et optimisation des portefeuilles d'investissement.
Industrie
Maintenance prédictive, chaîne d'approvisionnement, qualité, robotique.
ConstatL'apprentissage machine occupe une place centrale dans le paysage technologique actuel.
notes
- L'apprentissage machine occupe une place centrale dans le paysage technologique actuel et a un impact significatif dans divers domaines. Intelligence artificielle : composante essentielle de l'IA ; tirer des conclusions, apprendre à partir d'expériences passées et améliorer la performance sans programmation explicite. Informatique et technologie : vision par ordinateur, reconnaissance vocale, traduction automatique, chatbots. Santé : prédiction de maladies, analyse d'images médicales, découverte de médicaments ; personnalisation des traitements, dossiers médicaux électroniques. Finance : détection de fraudes, prévision des marchés, analyse de crédit, optimisation des portefeuilles. Industrie : maintenance prédictive, chaîne d'approvisionnement, qualité, robotique.
A.2.2 · Approches de l'apprentissage machine
Quatre approches : supervisé, non supervisé, semi-supervisé, par renforcement
Apprentissage supervisé
Le modèle est entraîné sur un ensemble étiqueté où les exemples d'entrée sont associés à des sorties désirées ; il apprend à prédire sur de nouvelles données à partir de ces associations.
Apprentissage non supervisé
Le modèle est exposé à des données non étiquetées et cherche à découvrir des modèles, des structures ou des relations intrinsèques.
Apprentissage semi-supervisé
Une combinaison des deux précédents : des données étiquetées et non étiquetées pour l'entraînement.
Apprentissage par renforcement
Le modèle apprend à prendre des décisions en interagissant avec son environnement ; il reçoit des récompenses ou des pénalités selon ses actions, ce qui guide son apprentissage.
notes
- Apprentissage supervisé : entraîné sur un ensemble de données étiquetées où les exemples d'entrée sont associés à des sorties désirées ; le modèle apprend à faire des prédictions sur de nouvelles données. Apprentissage non supervisé : données non étiquetées ; découvrir des modèles, des structures ou des relations intrinsèques. Apprentissage semi-supervisé : combinaison des deux, données étiquetées et non étiquetées. Apprentissage par renforcement : le modèle apprend en interagissant avec son environnement ; récompenses ou pénalités selon ses actions.
A.2.3 · Formalisation
Vecteurs, espaces, caractéristiques : le vocabulaire
Vecteur euclidien
Un objet géométrique caractérisé par sa magnitude (longueur) et sa direction. Couramment utilisé pour représenter des données comme des points dans un espace multidimensionnel, où chaque dimension correspond à une caractéristique ou une variable.
Espace vectoriel
Une collection de vecteurs qui peuvent être additionnés entre eux et multipliés par des nombres (scalaires).
Vecteur de caractéristiques
Un vecteur n-dimensionnel qui représente les caractéristiques ou les attributs d'une entité.
Espace de caractéristiques
L'espace vectoriel associé aux vecteurs de caractéristiques : chaque dimension représente une caractéristique, et les vecteurs positionnent les données dans cet espace.
notes
- Vecteur euclidien : un objet géométrique caractérisé par sa magnitude (longueur) et sa direction ; couramment utilisé pour représenter des données sous forme de points dans un espace multidimensionnel, où chaque dimension correspond à une caractéristique ou une variable. Espace vectoriel : une collection de vecteurs qui peuvent être additionnés entre eux et multipliés par des nombres (scalaires). Vecteur de caractéristiques (features) : un vecteur n-dimensionnel qui représente les caractéristiques ou les attributs d'une entité. Espace de caractéristiques : l'espace vectoriel associé aux vecteurs de caractéristiques ; chaque dimension représente une caractéristique particulière.
A.2.3 · Formalisation
Deux exemples de caractéristiques : pixels et fréquences de mots
Images
Les vecteurs de caractéristiques peuvent être construits à partir des valeurs des pixels : chaque pixel est une dimension, et un vecteur contient les valeurs de tous les pixels — une image devient un vecteur.
Textes
Les vecteurs sont souvent construits à partir de la fréquence d'apparition des mots, des phrases ou des tokens dans un document : le contenu textuel est représenté par des valeurs numériques, essentiel pour l'analyse de texte et la recherche d'informations.
notes
- Images : les vecteurs de caractéristiques peuvent être construits à partir des valeurs des pixels ; chaque pixel peut être considéré comme une dimension, et un vecteur de caractéristiques contiendra les valeurs de tous les pixels, permettant de représenter une image sous forme de vecteur. Textes : les vecteurs sont souvent construits à partir de la fréquence d'apparition des mots, des phrases, ou des tokens dans un document ; représenter le contenu textuel en utilisant des valeurs numériques, essentiel pour l'analyse de texte et la recherche d'informations.
A.2.3 · Formalisation
Construire des caractéristiques : de nouvelles variables à partir des anciennes
Construction de caractéristiques
Créer de nouvelles variables ou attributs à partir de celles déjà présentes dans les données. Cette étape peut être cruciale pour améliorer les performances en introduisant des informations pertinentes et en éliminant du bruit.
Opérateurs de construction
Des fonctions ou opérations mathématiques qui créent de nouvelles caractéristiques : opérateurs d'égalité (comparaisons), arithmétiques (addition, soustraction, multiplication, division), de tableau (min, max, moyenne, médiane…), fonctions de transformation, etc.
| Année de naissance | 1912 |
| Année de décès | 1954 |
| âge = décès − naissance | 42 |
Une nouvelle caractéristique « âge » créée par un opérateur arithmétique — Feature vector, Wikipedia
À retenirLa construction de caractéristiques est une étape essentielle du prétraitement : elle rend les données plus informatives pour les algorithmes d'apprentissage.
notes
- Construction de caractéristiques : créer de nouvelles variables ou attributs à partir de celles déjà présentes dans les données ; cruciale pour améliorer les performances en introduisant des informations pertinentes et en éliminant du bruit. Opérateurs de construction : fonctions ou opérations mathématiques qui créent de nouvelles caractéristiques ; opérateurs d'égalité (comparaisons), arithmétiques (addition, soustraction, multiplication, division), de tableau (min, max, moyenne, médiane, etc.), fonctions de transformation. https://en.wikipedia.org/wiki/Feature_vector. Exemple : soit Année de naissance et Année de décès deux caractéristiques existantes ; une nouvelle caractéristique « âge » est créée : âge = Année de décès − Année de naissance. La construction de caractéristiques est une étape essentielle du pipeline de prétraitement.
A.2.3 · Formalisation · apprentissage supervisé
Le supervisé en quatre objets : N, X, Y, D
Nombre d'exemples d'entraînement
La quantité d'exemples pour entraîner un modèle supervisé. Chaque exemple se compose d'un vecteur de caractéristiques (x) et de son label (y).
Espace de saisie des caractéristiques
L'ensemble de toutes les combinaisons possibles de vecteurs de caractéristiques utilisables en entrée du modèle ; défini par les caractéristiques extraites des données.
Espace des caractéristiques de sortie
L'ensemble de toutes les valeurs possibles que peuvent prendre les étiquettes ou labels.
Exemples d'entraînement
L'ensemble de données d'entraînement : des paires (x, y) où x est le vecteur de caractéristiques et y le label correspondant.
notes
- Le nombre d'exemples d'entraînement (N) : la quantité d'exemples pour entraîner un modèle supervisé ; chaque exemple se compose d'un vecteur de caractéristiques (x) et de son label (y). L'espace de saisie des caractéristiques (X) : l'ensemble de toutes les combinaisons possibles de vecteurs de caractéristiques utilisables comme entrée ; défini par les caractéristiques extraites. L'espace des caractéristiques de sortie (Y) : l'ensemble de toutes les valeurs possibles des étiquettes. Exemples d'entraînement (D) : paires (x, y).
A.2.3 · Formalisation · apprentissage supervisé
L'objectif : une fonction g, choisie dans G, jugée par F
Objectif de l'algorithme
Trouver une fonction g qui associe un vecteur de caractéristiques x à un label y. L'ensemble des fonctions possibles est l'espace des hypothèses G ; on choisit la g qui minimise l'erreur de prédiction sur les exemples et généralise bien.
Fonction d'évaluation
F est l'espace des fonctions d'évaluation utilisées pour juger les fonctions hypothétiques. L'objectif est de trouver la g qui obtient la fonction d'évaluation f la plus élevée, c'est-à-dire les prédictions les plus précises.
notes
- Objectif de l'algorithme d'apprentissage supervisé : trouver une fonction (g) qui associe un vecteur de caractéristiques (x) à un label (y) ; l'ensemble des fonctions possibles est appelé espace des hypothèses (G) ; choisir la fonction qui minimise l'erreur de prédiction sur les exemples d'entraînement et généralise bien. Fonction d'évaluation (F) : l'espace des fonctions d'évaluation utilisées pour évaluer la performance des fonctions hypothétiques ; trouver la fonction (g) qui renvoie la fonction d'évaluation (f) la plus élevée.
A.2.3 · Formalisation · apprentissage supervisé
Le supervisé, en notation
Cette formalisation est au cœur de l'apprentissage supervisé : apprendre à partir d'exemples étiquetés une fonction qui prédit précisément les étiquettes de nouvelles données non vues.
\(G\) : l'espace des hypothèses
telle que \(g\) renvoie la fonction d'évaluation la plus élevée
notes
- Soit N le nombre d'exemples d'entraînement ; X l'espace de saisie des caractéristiques ; Y l'espace des caractéristiques de sortie (des étiquettes) ; {(x₁, y₁), …, (x_N, y_N)} les N exemples d'entraînement, où x_i est le vecteur de caractéristiques du i-ème exemple et y_i son label. L'objectif de l'algorithme d'apprentissage supervisé est de trouver g : X → Y, où g est l'une des fonctions de l'ensemble G (espace des hypothèses). Fonction d'évaluation F : l'espace des fonctions d'évaluation, f : X × Y → R telle que g renvoie la fonction d'évaluation la plus élevée.
A.2.3 · Formalisation · apprentissage non supervisé
Non supervisé : Y n'est plus un ensemble d'étiquettes
Espace de saisie
L'ensemble de toutes les combinaisons possibles de vecteurs de caractéristiques utilisables en entrée, défini par les caractéristiques extraites des données.
Espace de sortie
L'ensemble des caractéristiques de sortie potentielles : non pas des étiquettes prédéfinies, mais des transformations, des représentations ou des caractéristiques extraites des données d'entrée.
Trouver une correspondance X → Y
Réduction de la dimensionnalité, classification automatique de données non étiquetées, détection d'anomalies, segmentation, représentation latente des données.
Mise en correspondance
Selon la tâche : en réduction de dimensionnalité, X est une représentation à haute dimension, Y la version réduite, avec moins de dimensions.
notes
- L'espace de saisie des caractéristiques (X) : l'ensemble de toutes les combinaisons possibles de vecteurs de caractéristiques utilisables en entrée. L'espace des caractéristiques de sortie (Y) : contrairement à l'apprentissage supervisé, Y ne consiste pas en des étiquettes prédéfinies, mais en des transformations, des représentations ou des caractéristiques extraites des données d'entrée. Objectif : trouver une correspondance entre X et Y ; réduction de la dimensionnalité, classification automatique de données non étiquetées, détection d'anomalies, segmentation, représentation latente. Mise en correspondance X → Y : selon la tâche ; en réduction de la dimensionnalité, X est une représentation à haute dimension et Y la version réduite.
A.2.3 · Formalisation · apprentissage non supervisé
Le non supervisé, en notation
L'apprentissage non supervisé explore et découvre des modèles, des structures ou des caractéristiques inhérentes aux données, sans étiquettes préalables : clustering, analyse en composantes principales (PCA), analyse en composantes indépendantes (ICA), et bien d'autres.
notes
- Soit X l'espace de saisie des caractéristiques ; Y l'espace des caractéristiques de sortie. L'objectif de l'algorithme d'apprentissage non supervisé est de trouver la mise en correspondance X → Y. L'apprentissage non supervisé est utilisé pour explorer et découvrir des modèles, des structures ou des caractéristiques inhérentes aux données, sans l'utilisation d'étiquettes ou de labels préalables ; couramment utilisé en clustering, analyse en composantes principales (PCA), analyse en composantes indépendantes (ICA), et bien d'autres.
A.2.3 · Formalisation · apprentissage semi-supervisé
Semi-supervisé : l étiquetés, u non étiquetés
Espace de saisie
L'ensemble de toutes les combinaisons possibles de vecteurs de caractéristiques utilisables en entrée du modèle semi-supervisé.
Espace de sortie
L'ensemble des caractéristiques de sortie potentielles ; contrairement au supervisé, pas nécessairement des étiquettes prédéfinies.
Exemples étiquetés
Un sous-ensemble d'exemples annotés ou étiquetés avec des valeurs de sortie connues.
Vecteurs non étiquetés
Les exemples non étiquetés, dont les valeurs de sortie ne sont pas connues.
notes
- L'espace de saisie des caractéristiques (X) ; l'espace des caractéristiques de sortie (Y) — pas nécessairement constitué d'étiquettes prédéfinies ; ensemble d'exemples étiquetés (l) : un sous-ensemble d'exemples annotés avec des valeurs de sortie connues ; ensemble des vecteurs de caractéristiques non étiquetés (u) : les exemples dont les valeurs de sortie ne sont pas connues.
A.2.3 · Formalisation · apprentissage semi-supervisé
Deux objectifs : transductif et inductif
Apprentissage transductif
Trouver des étiquettes correctes pour les exemples non étiquetés : prédire leurs valeurs de sortie sans nécessairement chercher à généraliser à de nouvelles données.
Apprentissage inductif
Trouver la bonne mise en correspondance entre les vecteurs de caractéristiques d'entrée et les caractéristiques de sortie, y compris la généralisation à de nouvelles données avec le modèle appris.
notes
- Objectif de l'algorithme d'apprentissage semi-supervisé : trouver des étiquettes correctes pour les exemples non étiquetés (apprentissage transductif), ainsi que trouver la bonne mise en correspondance entre les caractéristiques d'entrée et de sortie (apprentissage inductif). Apprentissage transductif : prédire les valeurs de sortie pour les exemples non étiquetés sans nécessairement généraliser. Apprentissage inductif : la bonne mise en correspondance entre entrées et sorties, avec généralisation à de nouvelles données.
A.2.3 · Formalisation · apprentissage semi-supervisé
Le semi-supervisé, en notation
À retenirTout problème d'apprentissage se formule pareil : des entrées X, des sorties Y, une fonction f à approcher à partir d'exemples.
notes
- Soit X l'espace de saisie des caractéristiques ; Y l'espace des caractéristiques de sortie ; {(x₁, y₁), …, (x_l, y_l)} l'ensemble d'exemples étiquetés ; {x_{l+1}, …, x_{l+u}} les u vecteurs de caractéristiques non étiquetés de X. L'objectif est de faire l'apprentissage transductif (trouver des étiquettes correctes pour {x_{l+1}, …, x_{l+u}}) et l'apprentissage inductif (trouver la bonne mise en correspondance X → Y). Tout problème d'apprentissage se formule pareil : des entrées X, des sorties Y, une fonction f à approcher à partir d'exemples.
A.3 · Classification · définition formelle
Classer, c'est attribuer à chaque vecteur une étiquette connue
l'attribution d'une étiquette connue à chaque vecteur de caractéristiques d'entrée
notes
- Soit X l'espace de saisie des caractéristiques, Y l'espace des caractéristiques de sortie (des étiquettes). L'objectif de l'algorithme de classification (ou classificateur) est de trouver {(x₁, y₁), …, (x_l, y_k)}, c'est-à-dire l'attribution d'une étiquette connue à chaque vecteur de caractéristiques d'entrée, où x_i ∈ X, y_i ∈ Y, |X| = l, |Y| = k, l ≥ k.
A.3 · Classificateurs
Deux types de classificateurs : binaire et multiclasse

Classificateurs binaires
Un algorithme de classification qui attribue un objet à l'une des deux classes.
Classificateurs multiclasses
Attribue un objet à une ou plusieurs classes.
notes
- Algorithme de classification. Deux types de classificateurs : les classificateurs binaires attribuent un objet à l'une des deux classes ; les classificateurs multiclasses attribuent un objet à une ou plusieurs classes. Figure : binaryclassifier.svg.
A.3 · Classificateurs linéaires
Un classificateur linéaire : un score par catégorie, par produit scalaire
Définition
Une fonction linéaire attribue un score à chaque catégorie possible en combinant le vecteur de caractéristiques d'une instance avec un vecteur de poids, par un produit scalaire.
La catégorie qui donne le score le plus élevé est attribuée à l'instance.
notes
- Fonction linéaire attribuant un score à chaque catégorie possible en combinant le vecteur de caractéristiques d'une instance avec un vecteur de poids, en utilisant un produit scalaire. Formalisation : soit X l'espace de saisie des caractéristiques et x_i ∈ X ; soit β_k un vecteur de poids pour la catégorie k ; score(x_i, k) = x_i · β_k, score pour l'attribution de la catégorie k à l'instance x_i. La catégorie qui donne le score le plus élevé est attribuée à l'instance.
A.3 · Évaluation
Vrais positifs, vrais négatifs : quand le modèle a raison
Vrais positifs
Les cas où le modèle prédit correctement la classe positive : il a identifié les exemples qui appartiennent réellement à la classe qu'il essaie de prédire.
Vrais négatifs
Les cas où le modèle prédit correctement la classe négative : il a identifié les exemples qui n'appartiennent pas à la classe qu'il essaie de prédire.
CadreÉvaluer un classificateur, c'est comparer ses prédictions à la réalité, cas par cas.
notes
- Dans le contexte de la classification, l'évaluation des performances d'un modèle implique la compréhension de différents types de prédictions qu'il peut faire par rapport à la réalité. Vrais positifs (VP/TP) : les cas où le modèle prédit correctement la classe positive ; il a correctement identifié les exemples qui appartiennent réellement à la classe. Vrais négatifs (VN/TN) : les cas où le modèle prédit correctement la classe négative. (Le cours original note « VN/FN » pour les vrais négatifs ; l'abréviation anglaise correcte est TN.)
A.3 · Évaluation
Positifs, négatifs, précision, rappel : les deux figures


notes
- Figures : positivenegative.svg (les vrais positifs et les vrais négatifs) et Precisionrecall.svg (précision et rappel).
A.3 · Évaluation
Précision et rappel, à partir de tp, fp, fn
La précision mesure la proportion de prédictions positives qui étaient effectivement correctes ; le rappel mesure la proportion d'exemples positifs réels correctement identifiés par le modèle.
notes
- Soit tp le nombre de vrais positifs, fp le nombre de faux positifs, fn le nombre de faux négatifs. La précision mesure la proportion de prédictions positives faites par le modèle qui étaient effectivement correctes, tandis que le rappel mesure la proportion d'exemples positifs réels qui ont été correctement identifiés. Précision p = tp / (tp + fp) ; rappel r = tp / (tp + fn).
A.3 · Évaluation
Le F1-score : la moyenne harmonique de la précision et du rappel
meilleure valeur à 1 (précision et rappel parfaits), pire à 0
Une mesure globale
Le F1-score tient compte à la fois de la précision et du rappel ; particulièrement utile lorsque les classes sont déséquilibrées.
Deux erreurs à la fois
Il tient compte des erreurs de type I (faux positifs) et de type II (faux négatifs), fournissant une mesure équilibrée de la performance.
notes
- Le F1-score est la moyenne harmonique de la précision et du rappel. Il fournit une mesure globale de la performance d'un modèle de classification, tenant compte à la fois de la précision et du rappel ; particulièrement utile lorsque les classes sont déséquilibrées. f1 = 2 · (p · r) / (p + r) ; meilleure valeur à 1 (précision et rappel parfaits) et pire à 0. Le F1-score tient compte à la fois des erreurs de type I (faux positifs) et des erreurs de type II (faux négatifs).
A.3 · Évaluation
Le F-bêta-score : pondérer le rappel β fois plus que la précision
\(\beta\) est choisi de telle sorte que le rappel est considéré comme \(\beta\) fois plus important que la précision
Quand le rappel compte plus
Le \(F_2\)-score est utilisé quand le rappel est jugé plus critique que la précision : des tâches où la détection des exemples positifs est particulièrement importante, même au prix d'un nombre plus élevé de faux positifs.
notes
- Le F_β-score utilise un facteur réel positif β, où β est choisi de telle sorte que le rappel est considéré comme β fois plus important que la précision : F_β = (1 + β²) · (p · r) / (β² · p + r). Exemple : F₂ score — souvent utilisé dans des situations où le rappel est jugé plus critique que la précision, par exemple des tâches où la détection des exemples positifs est particulièrement importante, même si cela entraîne un nombre plus élevé de faux positifs.
A.3 · Évaluation · F2
Cinq domaines où le F2-score est préféré
Détection de maladies
Pour les maladies graves, il est crucial d'identifier autant de cas positifs que possible, même au prix de quelques faux positifs.
Détection d'intrusion
Minimiser les faux négatifs (intrusions manquées) au profit de quelques faux positifs.
Recherche biomédicale
Quand la découverte de certaines caractéristiques ou protéines est critique, s'assurer qu'elles sont correctement identifiées.
Prévision de catastrophes naturelles
Tremblements de terre, tsunamis : minimiser les faux négatifs pour donner le maximum d'avertissements, même au prix d'alertes erronées.
Recherche en astronomie
La découverte de nouveaux objets célestes ou de phénomènes rares peut être cruciale ; le F2-score évalue les algorithmes de détection.
notes
- Le F₂-score est souvent utilisé dans des domaines où le rappel est considéré comme plus critique que la précision. Détection de maladies : identifier correctement autant de cas positifs que possible, même si cela conduit à quelques faux positifs. Sécurité et détection d'intrusion : minimiser les faux négatifs (intrusions manquées). Recherche biomédicale : découverte de caractéristiques ou protéines spécifiques. Prévision de catastrophes naturelles : minimiser les faux négatifs pour garantir le maximum d'avertissements. Recherche en astronomie : découverte de nouveaux objets célestes ou de phénomènes rares.
A.3 · Évaluation · matrice de confusion
La matrice de confusion : prédictions en lignes, réalité en colonnes
Une vue détaillée
La matrice de confusion est un outil essentiel de l'évaluation d'un classificateur : elle fournit une vue détaillée des prédictions du modèle par rapport aux classes réelles.
Diagonale et hors-diagonale
Chaque ligne représente les instances d'une classe prédite, chaque colonne les instances d'une classe réelle. Les prédictions correctes sont sur la diagonale ; les erreurs, en dehors de la diagonale principale.
notes
- La matrice de confusion est un outil essentiel dans l'évaluation des performances d'un système de classification. Elle fournit une vue détaillée des prédictions faites par le modèle par rapport aux classes réelles. Chaque ligne de la matrice représente les instances d'une classe prédite ; chaque colonne représente les instances d'une classe réelle ; toutes les prédictions correctes sont situées dans la diagonale ; les erreurs de prédiction sont représentées par des valeurs situées en dehors de la diagonale principale.
A.3 · Évaluation · matrice de confusion
Deux matrices sur MNIST : SVM contre perceptron
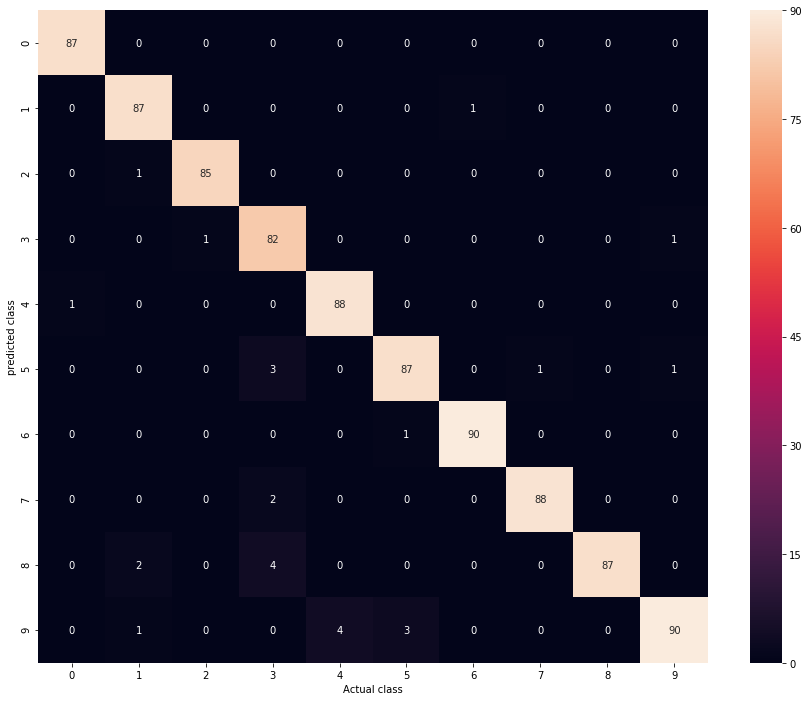
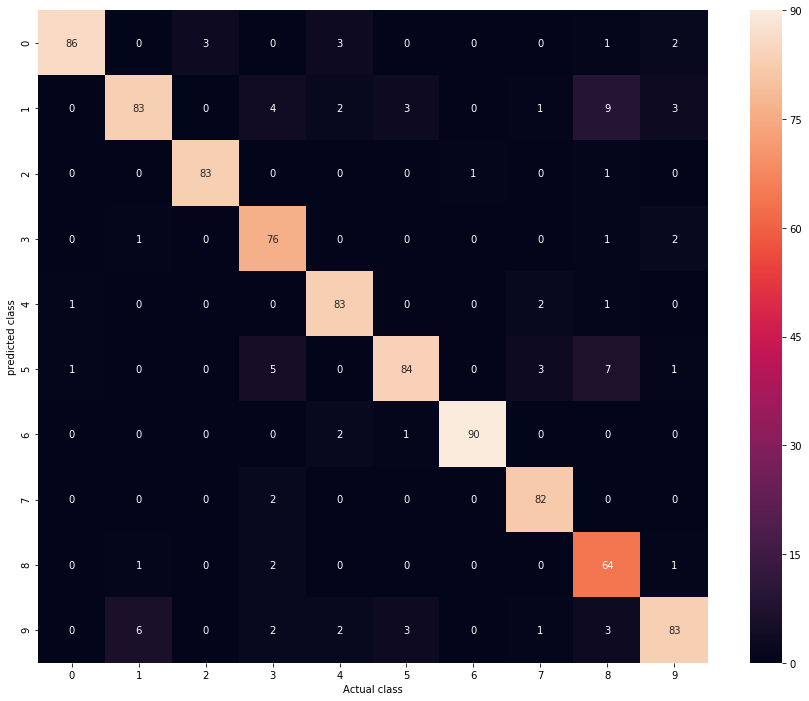
LecturePlus la diagonale est chargée et le reste vide, meilleur est le classificateur ; les cases hors diagonale disent quels chiffres sont confondus.
notes
- Matrice de confusion pour un classificateur SVM pour les chiffres manuscrits (MNIST) ; matrice de confusion pour un perceptron pour les chiffres manuscrits (MNIST).
A.3 · Classification multiclasse · [Aly 2005]
Multiclasse : transformer en binaire, ou étendre le binaire

Transformation en classification binaire
L'approche un contre le reste (un contre tous) ; l'approche un-contre-un.
Extension de la classification binaire
Réseaux de neurones ; k-voisins les plus proches ; la classification hiérarchique.
notes
- Classification multiclasse [Aly 2005] — transformation en classification binaire : l'approche un contre le reste (un contre tous), l'approche un-contre-un ; extension de la classification binaire : réseaux de neurones, k-voisins les plus proches, la classification hiérarchique. Figure : multiclassclassifier.svg.
A.3 · Classification multiclasse · un contre le reste
Un contre le reste : un classificateur binaire par classe

Principe
Entraîner un seul classificateur par classe, avec les échantillons de cette classe comme positifs et tous les autres comme négatifs.
Sortie de chaque classificateur
Chaque classificateur produit un score de confiance réel pour sa décision.
notes
- One-vs.-rest ou One-vs.-all (OvR, OvA) : entraîner un seul classificateur par classe, avec les échantillons de cette classe comme échantillons positifs et tous les autres comme négatifs. Chaque classificateur produit un score de confiance réel pour sa décision. Figure : onevsall.svg.
A.3 · Classification multiclasse · un contre le reste
Un contre le reste, formellement : K classificateurs, puis un argmax
prédire l'étiquette \(k\) dont le classificateur rapporte le score de confiance le plus élevé
À retenirMulticlasse = plusieurs classifieurs binaires (un contre tous, un contre un) ; softmax le fait en une couche.
notes
- Entrées : L, un apprenant (algorithme d'entraînement pour les classificateurs binaires) ; échantillons X ; étiquettes y, où y_i ∈ {1, …, K} est l'étiquette de l'échantillon X_i. Sortie : une liste de classificateurs f_k, où k ∈ {1, …, K}. Prendre des décisions signifie appliquer tous les classificateurs à un échantillon invisible x et prédire l'étiquette k pour laquelle le classificateur correspondant rapporte le score de confiance le plus élevé : ŷ = argmax_{k ∈ {1…K}} f_k(x). Multiclasse = plusieurs classifieurs binaires (un contre tous, un contre un) ; softmax le fait en une couche.
A.3 · Classification multiclasse · un contre un
Un contre un : K(K−1)/2 classificateurs et un vote

Entraînement
Un classificateur binaire par paire de classes : chacun reçoit les échantillons d'une paire de classes du jeu d'entraînement et apprend à distinguer ces deux classes.
Prédiction
Tous les \(K(K-1)/2\) classificateurs sont appliqués à un échantillon non vu ; la classe qui obtient le plus grand nombre de prédictions est prédite par le classificateur combiné.
notes
- One-vs.-one : nécessite l'entraînement de K(K−1)/2 classificateurs binaires ; chaque classificateur reçoit les échantillons d'une paire de classes du jeu de formation original, et doit apprendre à distinguer ces deux classes. Au moment de la prédiction, un système de vote est appliqué : tous les K(K−1)/2 classificateurs sont appliqués à un échantillon non vu et la classe qui a obtenu le plus grand nombre de prédictions est prédite par le classificateur combiné. Figure : onevsone.svg.
A.4 · Hyperparamètres · compléments
Trois hyperparamètres propres aux CNN
Taille de la fenêtre de convolution
Pour les réseaux convolutifs, la taille de la fenêtre utilisée pour la convolution.
Pas de la fenêtre de convolution
Le nombre d'unités entre chaque opération de convolution dans un CNN.
Taille de la fenêtre de pooling
Pour les CNN, la taille de la fenêtre utilisée pour l'opération de pooling.
notes
- Taille de la fenêtre de convolution (Convolutional Window Size) : pour les CNN, la taille de la fenêtre utilisée pour la convolution. Pas de la fenêtre de convolution (Convolutional Stride) : le nombre d'unités entre chaque opération de convolution. Taille de la fenêtre de pooling (Pooling Window Size) : la taille de la fenêtre utilisée pour le pooling.
A.4 · Hyperparamètres · compléments
Arrêt anticipé, répartition, augmentation de données
Arrêt anticipé
Arrêter l'entraînement dès que la performance sur un ensemble de validation cesse de s'améliorer, afin d'éviter le surajustement.
Répartition entraînement vs validation
La division de l'ensemble de données en ensembles distincts d'entraînement et de validation pour évaluer les performances pendant l'entraînement.
Augmentation de données
Créer de nouvelles données d'entraînement en appliquant des transformations, pour augmenter la diversité de l'ensemble.
notes
- Arrêt anticipé (Early Stopping) : arrêter l'entraînement dès que la performance sur un ensemble de validation cesse de s'améliorer, afin d'éviter le surajustement. Répartition entraînement vs validation : la division de l'ensemble de données en ensembles distincts d'entraînement et de validation. Augmentation de données : créer de nouvelles données d'entraînement en appliquant des transformations telles que la rotation, le redimensionnement, le décalage, etc.
A.4 · Hyperparamètres · compléments
Prétraitement et modèles pré-entraînés
Prétraitement des données
Les transformations appliquées aux données d'entrée avant de les fournir au réseau : normalisation, standardisation, redimensionnement, etc.
Modèles pré-entraînés
Utiliser des modèles déjà entraînés sur de grandes bases (comme ImageNet pour la vision) comme point de départ pour des tâches spécifiques.
À retenirLe réglage judicieux des hyperparamètres est souvent crucial ; il implique des expérimentations et des ajustements itératifs pour une tâche donnée.
notes
- Prétraitement des données : les transformations appliquées aux données d'entrée avant de les fournir au réseau (normalisation, standardisation, redimensionnement). Modèles pré-entraînés : utiliser des modèles déjà entraînés sur de grandes bases de données (comme ImageNet) comme point de départ pour des tâches spécifiques. Le réglage judicieux de ces hyperparamètres est souvent crucial pour obtenir des performances optimales ; il implique des expérimentations et des ajustements itératifs.
A.4 · Hyperparamètres · compléments
Combien de couches ? De 8 à plusieurs centaines
| Réseau | Nombre de couches |
|---|---|
| AlexNet | 8 |
| VGGNet | 16 |
| InceptionNet | 27 |
| GoogleNet | 22 |
| ResNet | 50, 101, 152, 200, 345 |
| DenseNet | 121, 169, 201 |
| MobileNetV2 | 13, 16, 23 |
LectureLes connexions résiduelles de ResNet sont ce qui a rendu 152 couches entraînables.
notes
- Nombre de couches : AlexNet 8 ; VGGNet 16 ; InceptionNet 27 ; GoogleNet 22 ; ResNet 50, 101, 152, 200, 345 ; DenseNet 121, 169, 201 ; MobileNetV2 13, 16, 23.
A.4 · Hyperparamètres · activations pour les CNN
ReLU, Leaky ReLU, sigmoïde, tanh, softmax dans les CNN
Rectified Linear Unit
Largement utilisée dans les CNN en raison de sa non-linéarité et de sa facilité de calcul.
Une variante
Permet un petit gradient pour les valeurs négatives, ce qui atténue certains problèmes de ReLU (neuron death) : \(f(x) = \max(\alpha x, x)\), \(\alpha > 0\) petit.
Sigmoid et Tanh
Utilisées dans certaines situations, notamment en couche de sortie pour la classification binaire.
Softmax
Comme pour les DNN, souvent utilisée en couche de sortie pour la classification multiclasse.
notes
- Fonctions d'activation pour les réseaux de neurones convolutifs (CNN). ReLU : largement utilisée dans les CNN en raison de sa non-linéarité et de sa facilité de calcul. Leaky ReLU : une variation de ReLU qui permet un petit gradient pour les valeurs négatives, aidant à atténuer certains problèmes liés à ReLU (neuron death) ; f(x) = max(αx, x) avec α > 0 (un petit coefficient). Sigmoid et Tanh : utilisées dans certaines situations, notamment en couche de sortie pour la classification binaire. Softmax : comme pour les DNN, souvent utilisée en couche de sortie pour la classification multiclasse.
A.5 · Noyaux de traitement d'image · noyau d'identité
Le noyau d'identité laisse l'image inchangée
Ce qu'il fait
Un noyau simple qui conserve l'image d'origine sans apporter de modifications. Lorsqu'il est appliqué à une image, il la laisse inchangée.
notes
- Noyau d'identité : un noyau simple qui conserve l'image d'origine sans apporter de modifications ; appliqué à une image, il laisse l'image inchangée. Matrice : 0 0 0 / 0 1 0 / 0 0 0.
A.5 · Noyaux de traitement d'image · détection de contours
Le filtre de Sobel met en évidence les variations d'intensité
Ce qu'il fait
Ce noyau est conçu pour détecter les contours dans une image ; il est aussi connu sous le nom de filtre de Sobel. Appliqué à une image, il met en évidence les variations d'intensité qui indiquent la présence de contours.
notes
- Noyau de détection de contours : conçu pour détecter les contours dans une image, également connu sous le nom de filtre de Sobel ; il met en évidence les variations d'intensité qui indiquent la présence de contours. Matrice : 1 0 −1 / 0 0 0 / −1 0 1.
A.5 · Noyaux de traitement d'image · box blur
Le box blur remplace chaque pixel par la moyenne de ses voisins
Ce qu'il fait
Ce noyau réalise une opération de flou simple, aussi appelée flou moyen : il attribue à chaque pixel la moyenne des valeurs de ses voisins, ce qui produit un effet de flou.
notes
- Box blur : ce noyau est utilisé pour réaliser une opération de flou simple, également connu sous le nom de flou moyen ; il attribue à chaque pixel la moyenne des valeurs de ses voisins, ce qui produit un effet de flou. Matrice : (1/9) × 1 1 1 / 1 1 1 / 1 1 1.
A.5 · Noyaux de traitement d'image · flou de Gauss 3 × 3
Le flou de Gauss pondère davantage le centre
Ce qu'il fait
Basé sur une distribution gaussienne, ce noyau réalise un flou plus doux et plus esthétique : les pixels du centre ont un poids plus élevé, ce qui donne un flou proche de celui d'une lentille de caméra.
notes
- Flou de Gauss 3 × 3 : basé sur une distribution gaussienne, utilisé pour réaliser un flou plus doux et plus esthétique ; les pixels du centre ont un poids plus élevé, créant un effet de flou qui ressemble à celui généré par une lentille de caméra. Matrice : (1/16) × 1 2 1 / 2 4 2 / 1 2 1.
A.6 · Détection d'objets · R-CNN
R-CNN : de l'image aux boîtes
À retenirLe CNN ne fait que classer des imagettes : la localisation vient des propositions de régions, pas du réseau — d'où la lenteur (2 000 passages par image) que Fast/Faster R-CNN puis YOLO ont éliminée.
notes
- Schéma : image → propositions de régions (Selective Search, ~2 000) → CNN par région → SVM par classe + régression de boîte → boîtes englobantes étiquetées.
A.6 · R-CNN · [Girshick 2014]
R-CNN : localiser et classer chaque objet d'une image
R-CNN (Regions with CNN features) est une famille de modèles pour la détection d'objets : localiser (boîte englobante) et classer chaque objet d'une image. L'idée est d'appliquer un CNN classificateur à des régions candidates de l'image plutôt qu'à l'image entière.
Génération de propositions de régions
Une étape préliminaire génère un ensemble de régions de l'image qui pourraient contenir un objet, généralement avec un algorithme bottom-up tel que Selective Search.
Extraction de caractéristiques
Pour chaque proposition de région, un CNN extrait des caractéristiques, utilisées pour classifier la région en tant qu'objet ou non.
Classification
Un classificateur SVM linéaire par classe décide si la région contient un objet de cette classe ; une régression affine ensuite la boîte englobante.
Évolutions
Fast R-CNN puis Faster R-CNN (2015, propositions apprises par un réseau) ; détecteurs à une seule passe, YOLO [Redmon 2016] et SSD, standards en temps réel ; DETR (2020), qui remplace les propositions de régions par un Transformer.
notes
- R-CNN (Regions with CNN features) est une famille de modèles pour la détection d'objets : localiser (boîte englobante) et classer chaque objet d'une image. L'idée est d'appliquer un CNN classificateur à des régions candidates plutôt qu'à l'image entière. Génération de propositions de régions : générer un ensemble de régions qui pourraient contenir un objet, généralement avec un algorithme bottom-up tel que Selective Search. Extraction de caractéristiques : pour chaque proposition, un CNN extrait des caractéristiques, utilisées pour classifier la région. Classification : un SVM linéaire par classe décide si la région contient un objet de cette classe ; une régression affine ensuite la boîte englobante. Évolutions : Fast R-CNN puis Faster R-CNN (2015, propositions apprises par un réseau) ; détecteurs à une seule passe, YOLO [Redmon 2016] et SSD, standards en temps réel ; DETR (2020), qui remplace les propositions de régions par un Transformer.
A.7 · Traduction automatique · approche manuelle
Traduire par des règles : un dictionnaire et de la grammaire
Approche manuelle
Des règles linguistiques (correspondances lexicales, règles de grammaire) définies par des linguistes spécifient comment traduire les éléments d'une langue source vers une langue cible.
| règles | « hello » → « bonjour » ; « I love » → « j'aime » |
| application | « Hello, I love programming » → « Bonjour, j'aime programming » |
| « programming » | pas de règle : il reste tel quel |
Limite : en pratique, les règles deviennent extrêmement nombreuses et complexes — contextes grammaticaux, variations lexicales, idiomes, etc.
notes
- Approche manuelle (règles) : des règles linguistiques (correspondances lexicales, règles de grammaire) définies par des linguistes spécifient comment traduire les éléments d'une langue source vers une langue cible. Exemple anglais vers français — règles : « hello » → « bonjour » ; « I love » → « j'aime » ; application : « Hello, I love programming » → « Bonjour, j'aime programming » ; « programming » n'a pas de règle, il reste tel quel. Limite : en pratique, les règles deviennent extrêmement nombreuses et complexes (contextes grammaticaux, variations lexicales, idiomes, etc.).
A.7 · Traduction automatique · approche statistique
Traduire par les statistiques : estimer la probabilité d'une traduction
Principe
L'approche statistique repose sur des modèles statistiques qui apprennent les relations entre les phrases dans différentes langues à partir de grands ensembles de données parallèles.
Différence avec les règles
Contrairement à l'approche manuelle fondée sur des règles définies par des experts, l'approche statistique utilise des statistiques et des probabilités pour estimer la probabilité d'une traduction donnée.
notes
- L'approche statistique de la traduction automatique repose sur l'utilisation de modèles statistiques pour apprendre les relations entre les phrases dans différentes langues à partir de grands ensembles de données parallèles. Contrairement à l'approche manuelle basée sur des règles linguistiques définies par des experts, l'approche statistique utilise des statistiques et des probabilités pour estimer la probabilité d'une traduction donnée.
A.7 · Traduction automatique · approche statistique
Les étapes de l'approche statistique (1/2)
- Ensembles de données parallèles
des phrases dans la langue source et leurs traductions dans la langue cible, nécessaires pour entraîner un modèle statistique
- Alignement de phrases
les phrases équivalentes dans les deux langues sont alignées : des paires de phrases qui servent de données d'entraînement
- Extraction de caractéristiques
à partir des paires alignées : n-grammes (groupes de mots consécutifs), séquences de mots, informations sur la syntaxe, etc.
notes
- Ensembles de données parallèles : pour entraîner un modèle statistique, des ensembles de données parallèles sont nécessaires ; ils contiennent des phrases dans la langue source et leurs traductions correspondantes dans la langue cible. Alignement de phrases : les phrases équivalentes dans les deux langues sont alignées ; cela crée des paires de phrases qui serviront de données d'entraînement. Extraction de caractéristiques : des caractéristiques pertinentes sont extraites des paires alignées ; n-grammes (groupes de mots consécutifs), séquences de mots, informations sur la syntaxe, etc.
A.7 · Traduction automatique · approche statistique
Les étapes de l'approche statistique (2/2)
- Entraînement du modèle
un modèle statistique, souvent fondé sur des modèles de langue conditionnels, apprend les probabilités conditionnelles des traductions données les phrases sources
- Estimation des probabilités
pour une nouvelle phrase, le modèle estime les probabilités des différentes traductions possibles en fonction de ses caractéristiques
- Sélection de la meilleure traduction
la traduction avec la probabilité la plus élevée est sélectionnée comme traduction finale
- Évaluation et ajustement
le modèle est évalué sur des ensembles de test ; si nécessaire, il est ajusté pour améliorer ses performances
Exemple concretDes modèles de langue conditionnels — par exemple des modèles de Markov conditionnels — pour estimer la probabilité d'une traduction donnée une phrase source.
notes
- Entraînement du modèle : un modèle statistique, souvent basé sur des méthodes probabilistes comme les modèles de langue conditionnels, est entraîné sur ces caractéristiques ; il apprend les probabilités conditionnelles des traductions données les phrases sources. Estimation des probabilités : lors de la traduction d'une nouvelle phrase, le modèle estime les probabilités des différentes traductions possibles. Sélection de la meilleure traduction : la traduction avec la probabilité la plus élevée est sélectionnée. Évaluation et ajustement : évalué sur des ensembles de données de test ; ajusté si nécessaire. Un exemple concret : l'utilisation de modèles de langues conditionnels (par exemple les modèles de Markov conditionnels) pour estimer la probabilité d'une traduction donnée une phrase source.
A.7 · Traduction automatique · approche hybride
Hybride : des règles là où elles existent, des statistiques ailleurs
L'approche hybride combine les approches manuelles (règles) et statistiques : des règles linguistiques pour certaines parties de la traduction, des modèles statistiques pour d'autres, afin d'exploiter les avantages des deux et d'obtenir des traductions de meilleure qualité.
Règles linguistiques
Des règles définies manuellement pour certaines constructions grammaticales, expressions idiomatiques ou autres aspects linguistiques spécifiques ; élaborées par des experts linguistes.
Ensembles de données parallèles
Comme dans l'approche statistique, des phrases dans la langue source et leurs traductions dans la langue cible sont nécessaires.
notes
- L'approche hybride dans la traduction automatique combine des éléments des approches manuelles (basées sur des règles) et des approches statistiques : utiliser des règles linguistiques pour certaines parties de la traduction tout en tirant parti de modèles statistiques pour d'autres parties du processus ; exploiter les avantages des deux approches pour des traductions de meilleure qualité. Règles linguistiques : définies manuellement pour certaines constructions grammaticales, expressions idiomatiques ou autres aspects spécifiques ; élaborées par des experts linguistes. Ensembles de données parallèles : comme dans l'approche statistique.
A.7 · Traduction automatique · approche hybride
Hybride : apprendre, appliquer les règles en priorité, intégrer
- Apprentissage statistique
un modèle statistique est entraîné sur les ensembles parallèles pour apprendre les relations entre les phrases des deux langues
- Application des règles
les règles linguistiques sont appliquées en priorité : si une partie du texte correspond à une règle prédéfinie, la traduction fondée sur la règle est utilisée
- Utilisation du modèle statistique
pour les parties du texte sans règle prédéfinie, le modèle statistique génère la traduction à partir des relations apprises
- Intégration des traductions partielles
les traductions issues des règles et celles du modèle statistique sont intégrées pour former la traduction finale
notes
- Apprentissage statistique : un modèle statistique est entraîné sur les ensembles de données parallèles pour apprendre les relations entre les phrases dans les deux langues. Application des règles : lors du processus de traduction, les règles linguistiques sont appliquées en priorité ; si une partie du texte correspond à une règle prédéfinie, la traduction basée sur la règle est utilisée. Utilisation du modèle statistique : pour les parties du texte qui ne correspondent pas à des règles prédéfinies. Intégration des traductions partielles : les traductions générées par les règles et celles générées par le modèle statistique sont intégrées pour former la traduction finale.
Références
Articles de recherche
- [Aly 2005] Aly, Mohamed. Survey on Multiclass Classification Methods. 2005.
- [Girshick 2014] Girshick, Ross, et al. « Rich feature hierarchies for accurate object detection and semantic segmentation ». arXiv:1311.2524, 2014. doi:10.48550/arXiv.1311.2524.
- [Jaakkola 2019] Jaakkola, H., et al. « Artificial Intelligence Yesterday, Today and Tomorrow. » 2019 42nd International Convention (MIPRO), 2019, pp. 860–67. IEEE Xplore.
- [Krizhevsky 2012] Krizhevsky A, Sutskever I, Hinton GE. « Imagenet classification with deep convolutional neural networks ». Advances in neural information processing systems, 2012, 25.
- [Pan 2016] Pan, Yunhe. « Heading toward Artificial Intelligence 2.0. » Engineering, vol. 2, no. 4, Dec. 2016, pp. 409–13.
- [Redmon 2016] Redmon, Joseph, et al. « You Only Look Once: Unified, Real-Time Object Detection ». Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 2016, p. 779‑88.
- [Vaswani 2017] Vaswani, Ashish, et al. « Attention Is All You Need ». Advances in Neural Information Processing Systems 30, 2017, p. 5998‑6008.
notes
- Références du cours original.
Références · Web
Sur le web
Web
- Google acquiert DNNresearch, spécialisé dans les réseaux de neurones profonds, Le Monde Informatique [1]
- Pourquoi Microsoft rachète LinkedIn, Le Monde Informatique [2]
- Scikit-learn · Perceptron
Wikipédia
- Perceptron · Multiclass classification · Multilayer perceptron · Feedforward neural network
- Recurrent neural network · Long short-term memory · Activation function
- Logique et raisonnement mathématique · Représentation des connaissances · Agent intelligent
- Calcul des propositions · Calcul des prédicats · Logique modale · Raisonnement automatisé · Connaissance · Gestion des connaissances
CréditsImages : Wikimedia Commons · Couleurs : Material Design Color Tool · Licence CC BY-SA 4.0.
notes
- Couleurs : Color Tool - Material Design. Images : Wikimedia Commons.