Cours 3 · 2026–2027
Apprentissage profond
Empiler des couches, apprendre des représentations.
John Samuel · CPE Lyon
Intelligence artificielle et Deep Learning
Réseaux profonds · Feedforward · Récurrents · Convolutionnels
a(l+1) = f(W(l)a(l) + b(l))la même équation, répétée couche après couche — et trois façons de la connecter
Fil rougeFeedforward, récurrent, convolutionnel : trois façons de connecter les mêmes neurones, pour trois types de données.
notes
Intelligence artificielle et Deep Learning — Apprentissage profond
John Samuel, CPE Lyon · Année 2026-2027 · Courriel : john.samuel@cpe.fr
 Licence CC BY-SA 4.0.
3.1 · Introduction · perceptron simple couche
Le perceptron simple couche : un seul neurone, une seule frontière
RappelEntrées pondérées, somme, fonction d'activation : le modèle de neurone artificiel du cours 2.
notes
- Perceptron simple couche (figure ArtificialNeuronModel_english.png du cours original, redessinée).
3.1 · Introduction · perceptron simple couche
Trois limites du perceptron simple couche
Le perceptron à simple couche, bien qu'il ait été une avancée significative dans le développement des réseaux de neurones artificiels, présente certaines limites importantes qui restreignent sa capacité à résoudre des problèmes complexes.
Fonctions linéaires seulement
Il ne peut apprendre que des fonctions linéaires et ne peut pas capturer des relations non linéaires complexes dans les données. Les problèmes sans frontière de décision linéaire dépassent ses capacités.
Incapacité à résoudre XOR
L'une des limitations emblématiques : en raison de sa nature linéaire, il ne peut pas séparer correctement les exemples positifs et négatifs du XOR, ni des problèmes similaires non linéaires.
Sensibilité aux données déséquilibrées
Quand une classe a significativement plus d'exemples que l'autre, l'apprentissage devient difficile, surtout si la classe minoritaire est mal représentée.
notes
- Linéarité : le perceptron à simple couche ne peut apprendre que des fonctions linéaires. Il ne peut pas capturer des relations non linéaires complexes dans les données ; les problèmes qui ne peuvent pas être résolus avec des frontières de décision linéaires dépassent ses capacités.
- Incapacité à résoudre le problème XOR : l'une des limitations emblématiques ; en raison de sa nature linéaire, il ne peut pas séparer correctement les exemples positifs et négatifs du XOR.
- Sensibilité aux données déséquilibrées : où une classe a significativement plus d'exemples que l'autre ; difficultés lors de l'apprentissage, surtout si la classe minoritaire est mal représentée.
3.1 · Introduction · perceptron simple couche
Quatre limites de plus — et la réponse : des couches cachées
Classification binaire seulement
Il ne peut pas être directement étendu aux tâches multiclasses sans modifications supplémentaires.
Dépendance aux caractéristiques linéaires
Ses résultats dépendent fortement de la linéarité des caractéristiques ; sinon il ne peut pas les exploiter efficacement.
Pas d'apprentissage hiérarchique
Il ne peut pas apprendre des représentations hiérarchiques ; les réseaux profonds capturent des caractéristiques à différents niveaux d'abstraction.
Sensibilité aux valeurs aberrantes
Les valeurs aberrantes dans les données peuvent affecter négativement ses performances.
RéponseDes architectures plus complexes — les réseaux profonds à plusieurs couches cachées — donnent une représentation plus riche et non linéaire des données.
notes
- Uniquement pour des tâches de classification binaire : il ne peut pas être directement étendu pour traiter des tâches de classification multiclasse sans des modifications supplémentaires. Dépendance aux caractéristiques linéaires : si les caractéristiques ne sont pas linéaires, le perceptron ne peut pas les exploiter efficacement. Manque de capacité d'apprentissage hiérarchique : les réseaux profonds, avec plusieurs couches cachées, capturent des caractéristiques à différents niveaux d'abstraction. Sensibilité aux valeurs aberrantes (outliers).
- Pour surmonter ces limitations, des architectures plus complexes telles que les réseaux de neurones profonds avec plusieurs couches cachées ont été développées. Ces réseaux permettent une représentation plus riche et non linéaire des données, rendant possible la résolution de problèmes plus complexes.
3.1 · Introduction · perceptron multicouche
Une couche cachée suffit pour XOR
À retenirLa non-linéarité de la couche cachée courbe la frontière : le perceptron multicouche surmonte la limite du simple couche.
notes
- Perceptron multicouche (figure XOR_perceptron_net.png du cours original, redessinée).
3.1 · Introduction · perceptron multicouche
Le perceptron multicouche modélise le non-linéaire et apprend par niveaux
Le perceptron multicouche, également appelé réseau de neurones à plusieurs couches, surmonte plusieurs des limitations du perceptron à simple couche en introduisant des couches cachées et des fonctions d'activation non linéaires.
Capacité à modéliser des relations non linéaires
Contrairement au perceptron à simple couche, le perceptron multicouche est capable de capturer des relations non linéaires complexes dans les données. Les couches cachées et les fonctions d'activation non linéaires permettent d'apprendre des représentations plus riches.
Apprentissage hiérarchique
Le perceptron multicouche a la capacité d'apprendre des représentations hiérarchiques des données. Les différentes couches cachées peuvent extraire des caractéristiques à différents niveaux d'abstraction.
notes
- Le perceptron multicouche surmonte plusieurs des limitations du perceptron à simple couche en introduisant des couches cachées et des fonctions d'activation non linéaires. Capacité à modéliser des relations non linéaires : couches cachées et activations non linéaires permettent d'apprendre des représentations plus riches. Apprentissage hiérarchique : les différentes couches cachées extraient des caractéristiques à différents niveaux d'abstraction.
3.1 · Introduction · perceptron multicouche
Adapté aux tâches complexes, au multiclasse et aux données déséquilibrées
Adaptabilité à des tâches complexes
Plus adapté pour la vision par ordinateur, la reconnaissance vocale, la traduction automatique, etc., où les relations dans les données sont souvent non linéaires.
Gestion de données déséquilibrées
Il peut mieux gérer les problèmes de données déséquilibrées en raison de sa capacité à apprendre des représentations complexes.
Classification multiclasse
Il peut être utilisé pour des tâches de classification multiclasse sans modification majeure.
Diverses fonctions d'activation
Il peut utiliser différentes fonctions d'activation dans différentes couches, ce qui augmente sa flexibilité pour modéliser des relations complexes.
notes
- Adaptabilité à des tâches complexes : vision par ordinateur, reconnaissance vocale, traduction automatique, où les relations dans les données sont souvent non linéaires. Gestion de données déséquilibrées : grâce à sa capacité à apprendre des représentations complexes. Tâches de classification multiclasse : sans modification majeure. Adaptabilité à diverses fonctions d'activation : différentes fonctions dans différentes couches.
3.1 · Introduction · réseau profond
« Profond » veut dire : plus de trois couches
notes
- Le terme « profond » se réfère à un réseau qui a un grand nombre de couches, généralement plus de trois. Ces réseaux sont également appelés « réseaux de neurones profonds » ou « réseaux neuronaux profonds ». Les réseaux de neurones profonds ont été rendus populaires par leurs capacités à apprendre des représentations hiérarchiques complexes.
3.1 · Exemple · TensorFlow / Keras
Un réseau en Keras : créer le modèle, empiler les couches
# Importation des bibliothèques nécessaires (TensorFlow / Keras 3)
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import Input, Dense
from tensorflow.keras.optimizers import SGD

# Étape 1: Création d'un modèle séquentiel
model = Sequential()

# Étape 2: Déclaration de la forme de l'entrée (3 caractéristiques),
# puis ajout d'une couche dense de 4 neurones, activation 'relu'
model.add(Input(shape=(3,)))
model.add(Dense(4, activation='relu'))
Une pile linéaire de couches ; chaque Dense est entièrement connectée à la précédente.
notes
# Importation des bibliothèques nécessaires (TensorFlow / Keras 3)
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import Input, Dense
from tensorflow.keras.optimizers import SGD
# Étape 1: Création d'un modèle séquentiel
model = Sequential()
# Étape 2: Déclaration de la forme de l'entrée (3 caractéristiques),
# puis ajout d'une couche dense de 4 neurones, activation 'relu'
model.add(Input(shape=(3,)))
model.add(Dense(4, activation='relu'))
3.1 · Exemple · TensorFlow / Keras
Sortie softmax, puis compilation : optimiseur, perte, métrique
# Étape 3: Ajout d'une couche dense de sortie avec une activation softmax
# 2 neurones (un par classe) pour une classification binaire ; softmax
# donne des probabilités
model.add(Dense(units=2, activation='softmax'))

# Étape 4: Compilation du modèle
# Optimiseur : descente de gradient stochastique (SGD), taux 0.01
# Perte : 'categorical_crossentropy' (classification, étiquettes one-hot)
# Métrique : 'accuracy' (précision)
sgd = SGD(learning_rate=0.01)
model.compile(loss='categorical_crossentropy', optimizer=sgd,
              metrics=['accuracy'])
| optimizer | SGD, lr 0.01 |
| loss | categorical_crossentropy |
| metrics | accuracy |
Rien n'est encore appris : compile() prépare l'entraînement, fit() l'exécute.
notes
# Étape 3: Ajout d'une couche dense de sortie avec une activation softmax
# 2 neurones (un par classe) pour une classification binaire ; softmax
# donne des probabilités
model.add(Dense(units=2, activation='softmax'))
# Étape 4: Compilation du modèle
# Optimiseur : descente de gradient stochastique (SGD), taux 0.01
# Perte : 'categorical_crossentropy' (classification, étiquettes one-hot)
# Métrique : 'accuracy' (précision)
sgd = SGD(learning_rate=0.01)
model.compile(loss='categorical_crossentropy', optimizer=sgd,
              metrics=['accuracy'])
3.1 · Exemple · TensorFlow / Keras
Les quatre étapes, en clair
- Un modèle séquentiel
une pile linéaire de couches
- La forme de l'entrée, puis une couche dense
on déclare la forme (3,) — chaque exemple d'entraînement a trois caractéristiques — puis on ajoute une couche dense avec 4 neurones utilisant la fonction d'activation ReLU
- Une couche dense de sortie
2 neurones avec softmax : couramment utilisé pour la classification binaire, fournissant des probabilités pour chaque classe
- La compilation
l'optimiseur (SGD avec un taux d'apprentissage de 0.01), la fonction de perte ('categorical_crossentropy', adaptée à une classification avec étiquettes one-hot), et les métriques de performance ('accuracy' pour mesurer la précision du modèle)
notes
- Étape 1 : on crée un modèle séquentiel, qui est une pile linéaire de couches. Étape 2 : on déclare la forme de l'entrée (3,) — chaque exemple d'entraînement a trois caractéristiques — puis on ajoute une couche dense avec 4 neurones utilisant la fonction d'activation ReLU. Étape 3 : on ajoute une couche dense de sortie avec 2 neurones utilisant la fonction d'activation softmax ; couramment utilisé pour les tâches de classification binaire, fournissant des probabilités pour chaque classe. Étape 4 : on compile le modèle en spécifiant l'optimiseur (SGD avec un taux d'apprentissage de 0.01), la fonction de perte ('categorical_crossentropy', adaptée à une classification avec étiquettes one-hot), et les métriques de performance ('accuracy').
3.1 · Exemple · TensorFlow Playground
Voir un réseau apprendre : TensorFlow Playground
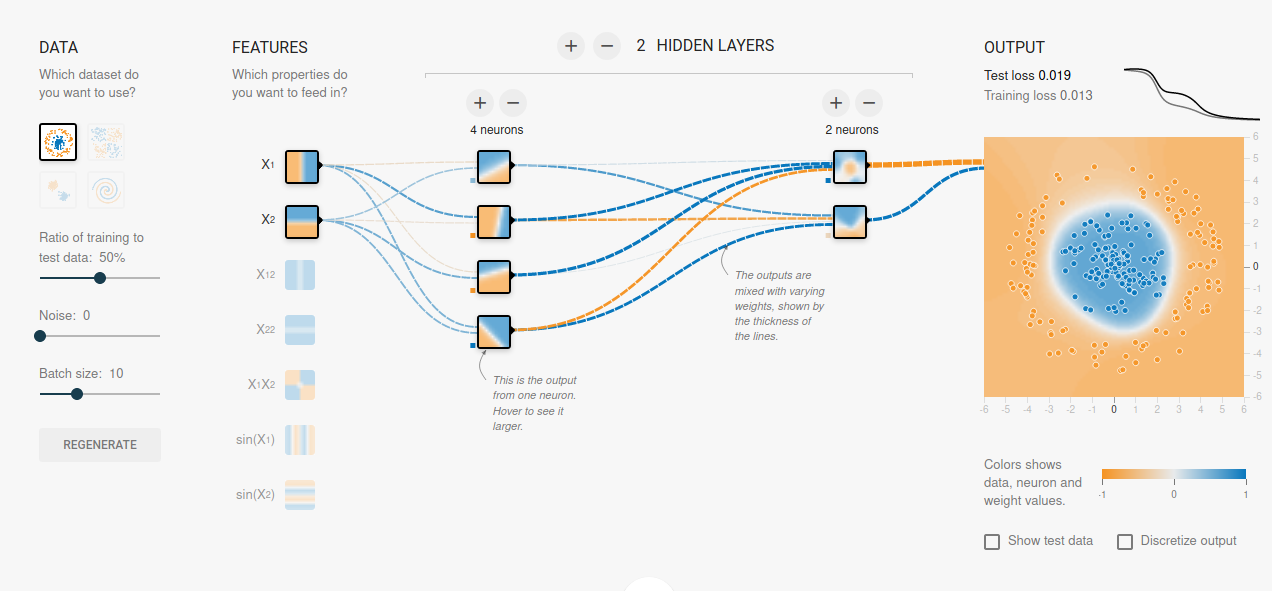
À essayerChanger le nombre de couches, l'activation et le taux d'apprentissage, et regarder la frontière se former.
notes
- Capture d'écran de TensorFlow Playground. Source : https://playground.tensorflow.org/
3.1 · Exemple · TensorFlow Playground
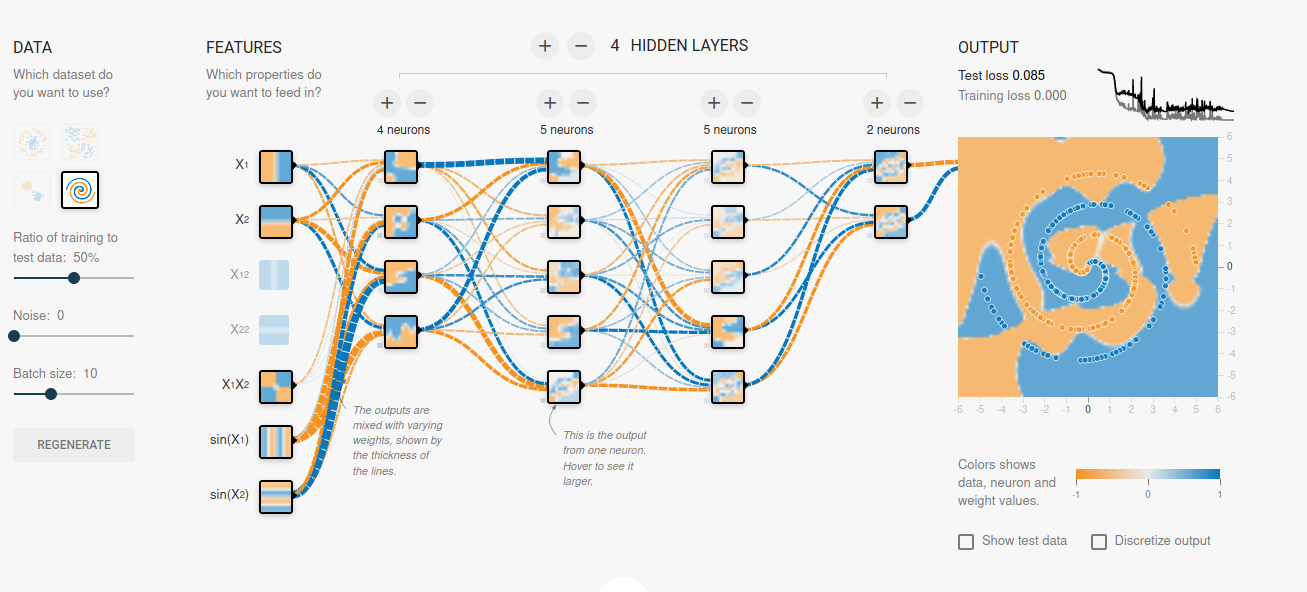
Le même problème, un autre réseau
notes
- Seconde capture d'écran de TensorFlow Playground. Source : https://playground.tensorflow.org/
3.1 · Exemple complet · Iris
Un pipeline complet en Keras : les imports
import numpy as np
import tensorflow as tf
from tensorflow.keras.callbacks import EarlyStopping, ModelCheckpoint
from tensorflow.keras.layers import Input, Dense
from tensorflow.keras.models import Sequential
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import OneHotEncoder
from sklearn.datasets import load_iris
import matplotlib.pyplot as plt
- 1 · Données
Iris, one-hot, split, normalisation
- 2 · Modèle
deux couches cachées, softmax à 3
- 3 · Callbacks
arrêt anticipé, sauvegarde
- 4 · Entraînement
fit() avec validation
- 5–7 · Évaluer, tracer, prédire
evaluate(), courbes, predict()
notes
import numpy as np
import tensorflow as tf
from tensorflow.keras.callbacks import EarlyStopping, ModelCheckpoint
from tensorflow.keras.layers import Input, Dense
from tensorflow.keras.models import Sequential
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import OneHotEncoder
from sklearn.datasets import load_iris
import matplotlib.pyplot as plt
3.1 · Exemple complet · Iris
1 · Préparer les données : one-hot, séparation, normalisation
# 1. Préparation des données
# Charger le jeu de données IRIS
data = load_iris()
X = data.data                        # Les caractéristiques
y = data.target.reshape(-1, 1)       # Les étiquettes
# Encodage en one-hot des étiquettes
encoder = OneHotEncoder(sparse_output=False)
y_encoded = encoder.fit_transform(y)
# Division en ensembles d'entraînement et de test
X_train, X_test, y_train, y_test = train_test_split(X, y_encoded, test_size=0.2, random_state=42)
# Normalisation des données
mean = X_train.mean(axis=0)
std = X_train.std(axis=0)
X_train = (X_train - mean) / std
X_test = (X_test - mean) / std
| X | (150, 4) |
| y_encoded | (150, 3) |
| X_train / X_test | 120 / 30 |
| setosa → one-hot | [1, 0, 0] |
La moyenne et l'écart-type sont calculés sur l'entraînement seulement, puis appliqués au test.
notes
# 1. Préparation des données
# Charger le jeu de données IRIS
data = load_iris()
X = data.data # Les caractéristiques
y = data.target.reshape(-1, 1) # Les étiquettes
# Encodage en one-hot des étiquettes
encoder = OneHotEncoder(sparse_output=False)
y_encoded = encoder.fit_transform(y)
# Division en ensembles d'entraînement et de test
X_train, X_test, y_train, y_test = train_test_split(X, y_encoded, test_size=0.2, random_state=42)
# Normalisation des données
mean = X_train.mean(axis=0)
std = X_train.std(axis=0)
X_train = (X_train - mean) / std
X_test = (X_test - mean) / std
3.1 · Exemple complet · Iris
2 · Le modèle : 4 → 10 → 10 → 3
# 2. Création du modèle
model = Sequential([
    Input(shape=(X.shape[1],)),
    Dense(10, activation='relu'),
    Dense(10, activation='relu'),
    Dense(3, activation='softmax')
])
# Compilation du modèle
model.compile(optimizer='adam',
              loss='categorical_crossentropy',
              metrics=['accuracy'])
notes
# 2. Création du modèle
model = Sequential([
    Input(shape=(X.shape[1],)),
    Dense(10, activation='relu'),
    Dense(10, activation='relu'),
    Dense(3, activation='softmax')
])
# Compilation du modèle
model.compile(optimizer='adam',
              loss='categorical_crossentropy',
              metrics=['accuracy'])
3.1 · Exemple complet · Iris
3 · Deux callbacks : s'arrêter à temps, garder le meilleur
# 3. Définition des callbacks
# Arrêt anticipé pour éviter le surapprentissage
early_stopping = EarlyStopping(monitor='val_loss', patience=5,
                               restore_best_weights=True)
# Sauvegarde du meilleur modèle
checkpoint = ModelCheckpoint('best_model.keras', monitor='val_loss',
                             save_best_only=True)
| EarlyStopping | val_loss, patience 5 |
| ModelCheckpoint | best_model.keras |
Si la perte de validation ne baisse plus pendant 5 époques, on s'arrête et on revient aux meilleurs poids ; le meilleur modèle est aussi écrit sur disque.
notes
# 3. Définition des callbacks
# Arrêt anticipé pour éviter le surapprentissage
early_stopping = EarlyStopping(monitor='val_loss', patience=5, restore_best_weights=True)
# Sauvegarde du meilleur modèle
checkpoint = ModelCheckpoint('best_model.keras', monitor='val_loss', save_best_only=True)
3.1 · Exemple complet · Iris
4 · Entraîner : fit() avec une part de validation
# 4. Entraînement du modèle
history = model.fit(X_train, y_train,
                    validation_split=0.2,
                    epochs=100,
                    batch_size=4,
                    callbacks=[early_stopping, checkpoint])
| validation_split | 20 % de l'entraînement |
| epochs | 100 au plus |
| batch_size | 4 exemples par mise à jour |
| history | perte et précision par époque |
notes
# 4. Entraînement du modèle
history = model.fit(X_train, y_train,
                    validation_split=0.2,
                    epochs=100,
                    batch_size=4,
                    callbacks=[early_stopping, checkpoint])
3.1 · Exemple complet · Iris
5 · Évaluer sur les données jamais vues
# 5. Évaluation du modèle
test_loss, test_accuracy = model.evaluate(X_test, y_test)
print(f"Test Loss: {test_loss:.4f}")
print(f"Test Accuracy: {test_accuracy:.4f}")
| Test Loss | 0.0912 |
| Test Accuracy | 0.9667 |
29 fleurs sur 30 bien classées — valeurs illustratives, elles varient d'un entraînement à l'autre.
notes
# 5. Évaluation du modèle
test_loss, test_accuracy = model.evaluate(X_test, y_test)
print(f"Test Loss: {test_loss:.4f}")
print(f"Test Accuracy: {test_accuracy:.4f}")
3.1 · Exemple complet · Iris
6 · Tracer perte et précision, entraînement contre validation
# 6. Visualisation des performances
plt.figure(figsize=(12, 5))
# Courbe de perte
plt.subplot(1, 2, 1)
plt.plot(history.history['loss'], label='Train Loss')
plt.plot(history.history['val_loss'], label='Validation Loss')
plt.xlabel('Epochs'); plt.ylabel('Loss'); plt.title('Courbe de perte'); plt.legend()
# Courbe de précision
plt.subplot(1, 2, 2)
plt.plot(history.history['accuracy'], label='Train Accuracy')
plt.plot(history.history['val_accuracy'], label='Validation Accuracy')
plt.xlabel('Epochs'); plt.ylabel('Accuracy'); plt.title('Courbe de précision'); plt.legend()
plt.show()
LectureQuand la perte de validation remonte alors que celle d'entraînement baisse encore, le modèle surapprend : c'est là que l'arrêt anticipé intervient.
notes
# 6. Visualisation des performances # Visualisation de la courbe de perte et de précision plt.figure(figsize=(12, 5)) # Courbe de perte plt.subplot(1, 2, 1) plt.plot(history.history['loss'], label='Train Loss') plt.plot(history.history['val_loss'], label='Validation Loss') plt.xlabel('Epochs') plt.ylabel('Loss') plt.title('Courbe de perte') plt.legend() # Courbe de précision plt.subplot(1, 2, 2) plt.plot(history.history['accuracy'], label='Train Accuracy') plt.plot(history.history['val_accuracy'], label='Validation Accuracy') plt.xlabel('Epochs') plt.ylabel('Accuracy') plt.title('Courbe de précision') plt.legend() plt.show()- Les courbes affichées sont illustratives (allure typique), pas la sortie réelle d'un entraînement.
3.1 · Exemple complet · Iris
7 · Recharger le meilleur modèle et prédire
# 7. Chargement du meilleur modèle sauvegardé et prédiction
best_model = tf.keras.models.load_model('best_model.keras')
# Prédiction sur les données de test
y_pred = best_model.predict(X_test)
y_pred_classes = np.argmax(y_pred, axis=1)
y_true_classes = np.argmax(y_test, axis=1)
# Affichage de quelques prédictions pour vérifier le modèle
print("Vraies classes:", y_true_classes)
print("Classes prédites:", y_pred_classes)
| Vraies classes | [1 0 2 1 1 0 …] |
| Classes prédites | [1 0 2 1 1 0 …] |
predict() renvoie trois probabilités par fleur ; argmax choisit la classe la plus probable.
notes
# 7. Chargement du meilleur modèle sauvegardé et prédiction
best_model = tf.keras.models.load_model('best_model.keras')
# Prédiction sur les données de test
y_pred = best_model.predict(X_test)
y_pred_classes = np.argmax(y_pred, axis=1)
y_true_classes = np.argmax(y_test, axis=1)
# Affichage de quelques prédictions pour vérifier le modèle
print("Vraies classes:", y_true_classes)
print("Classes prédites:", y_pred_classes)
3.1 · Composants · organisation
L'information traverse des couches ; chaque connexion a un poids
Un réseau de neurones profond est une architecture complexe où l'information circule de la couche d'entrée à travers les couches cachées jusqu'à la couche de sortie. Chaque connexion entre les neurones est associée à un poids qui est ajusté pendant le processus d'apprentissage pour optimiser les performances du modèle sur la tâche spécifique. L'utilisation de plusieurs couches cachées permet au réseau d'apprendre des représentations de plus en plus abstraites et complexes des données.
Organisation en plusieurs couches
Un réseau de neurones profond est structuré en plusieurs couches : une couche d'entrée, plusieurs couches cachées et une couche de sortie. Chaque couche est composée de neurones, également appelés nœuds ou unités.
Connexions entre les neurones
Les neurones d'une couche sont connectés aux neurones de la couche immédiatement précédente et de la couche immédiatement suivante. Chaque connexion est associée à un poids qui est ajusté pendant l'apprentissage.
notes
- Un réseau de neurones profond est une architecture complexe où l'information circule de la couche d'entrée à travers les couches cachées jusqu'à la couche de sortie. Chaque connexion entre les neurones est associée à un poids qui est ajusté pendant le processus d'apprentissage. L'utilisation de plusieurs couches cachées permet au réseau d'apprendre des représentations de plus en plus abstraites et complexes des données.
- Organisation en plusieurs couches : couche d'entrée, plusieurs couches cachées, couche de sortie ; chaque couche est composée de neurones (nœuds, unités). Connexions entre les neurones : les neurones d'une couche sont connectés aux neurones de la couche immédiatement précédente et suivante ; chaque connexion est associée à un poids ajusté pendant l'apprentissage.
3.1 · Composants · organisation
Entrée, sortie, et entre les deux : zéro ou plusieurs couches cachées
Couche d'entrée
Elle reçoit les données externes, souvent représentées par des caractéristiques d'un ensemble de données. Chaque neurone dans la couche d'entrée correspond à une caractéristique spécifique.
Couche de sortie
Elle produit le résultat final du modèle en fonction de la tâche : classification d'une image, prédiction d'une valeur, etc. Le nombre de neurones dépend du type de problème — par exemple un neurone pour chaque classe dans une classification.
Couches cachées
Il peut y en avoir zéro ou plusieurs. Elles extraient des caractéristiques complexes des données d'entrée ; chaque neurone d'une couche cachée combine les informations de la couche précédente pour apprendre des représentations hiérarchiques.
notes
- Couche d'entrée : la première couche du réseau ; elle reçoit les données externes, souvent représentées par des caractéristiques ; chaque neurone correspond à une caractéristique spécifique. Couche de sortie : la dernière couche ; elle produit le résultat final selon la tâche (classification d'une image, prédiction d'une valeur…) ; le nombre de neurones dépend du problème (un neurone par classe en classification). Couches cachées : entre l'entrée et la sortie, zéro ou plusieurs ; extraction de caractéristiques complexes ; chaque neurone combine les informations de la couche précédente pour apprendre des représentations hiérarchiques.
3.1 · Composants · connectivité
Entièrement connecté : chaque neurone parle à tous ceux de la couche suivante
Connectivité entièrement connectée
Chaque neurone d'une couche est connecté à chaque neurone de la couche suivante : toutes les informations de la couche précédente sont transmises à chaque neurone de la couche suivante. C'est la configuration la plus courante dans les couches totalement connectées, généralement présentes dans les parties du réseau proches de la sortie.
Coûtn × m poids entre deux couches de n et m neurones : c'est ce que la convolution évitera pour les images.
notes
- Connectivité entièrement connectée : dans une connectivité entièrement connectée, chaque neurone d'une couche est connecté à chaque neurone de la couche suivante. Cela signifie que toutes les informations de la couche précédente sont transmises à chaque neurone de la couche suivante. C'est la configuration la plus courante dans les couches totalement connectées, généralement présentes dans les parties du réseau proches de la sortie.
3.1 · Composants · connectivité
Pooling : un groupe de neurones se résume en un seul
Réduire la dimension
Le pooling réduit la dimension des cartes de caractéristiques tout en préservant les informations essentielles. En termes de connectivité, un groupe de neurones dans une couche est connecté à un seul neurone dans la couche suivante.
Deux variantes
Dans le pooling max, chaque groupe de neurones transmet uniquement l'activation maximale à un neurone de la couche suivante. Cela réduit le nombre de neurones : utile pour la complexité computationnelle et pour limiter le surapprentissage.
notes
- Connectivité par le biais de la mise en commun (pooling) : le pooling est une opération souvent utilisée pour réduire la dimension des cartes de caractéristiques tout en préservant les informations essentielles. Dans le contexte de la connectivité, un groupe de neurones dans une couche peut être connecté à un seul neurone dans la couche suivante. Il existe différents types de pooling, comme le pooling max et le pooling moyen. Dans le pooling max, chaque groupe de neurones transmet uniquement l'activation maximale à un neurone dans la couche suivante. Cela réduit le nombre de neurones, ce qui peut être utile pour la gestion de la complexité computationnelle et la réduction du surapprentissage.
3.1 · Composants · connectivité
Feedforward : l'information ne circule que dans un sens
Réseaux de neurones en aval
Les réseaux feedforward ne permettent pas de cycles entre les couches. L'information circule dans une seule direction, de l'entrée à la sortie, sans boucles récurrentes. Chaque couche traite indépendamment les données et transmet les résultats à la suivante.
Des exemples indépendants
Couramment utilisés pour des tâches où les données peuvent être traitées indépendamment, comme la classification d'images ou la reconnaissance vocale : chaque exemple est traité seul.
À retenirLes réseaux en aval sont adaptés aux tâches où chaque exemple de données peut être traité indépendamment des autres.
notes
- Réseaux de neurones en aval (feedforward neural networks) : ils ne permettent pas de cycles entre les couches. L'information circule dans une seule direction, de la couche d'entrée à la couche de sortie, sans boucles récurrentes. Chaque couche traite indépendamment les données et transmet les résultats à la couche suivante. Ces réseaux sont couramment utilisés pour des tâches où les données peuvent être traitées de manière indépendante, comme la classification d'images, la reconnaissance vocale, etc. Les réseaux de neurones en aval sont plus adaptés à des tâches où chaque exemple de données peut être traité de manière indépendante.
3.1 · Composants · connectivité
Récurrent : des boucles pour se souvenir
Réseaux récurrents
Ils permettent des connexions entre les neurones de la même couche ou des couches précédentes : des boucles, qui laissent l'information circuler de manière répétée et prendre en compte les séquences et les dépendances temporelles.
Données séquentielles
Séquences temporelles, phrases en traitement du langage naturel (NLP), etc. La connectivité récurrente permet aux informations de persister et d'être mises à jour à chaque pas de temps.
notes
- Réseaux récurrents : ils permettent des connexions entre les neurones de la même couche ou des couches précédentes. Ils ont des boucles ou des connexions récurrentes, permettant aux informations de circuler à travers le réseau de manière répétée ; ces connexions permettent de prendre en compte les séquences et les dépendances temporelles dans les données. Ils sont souvent utilisés pour traiter des données séquentielles telles que des séquences temporelles, des phrases (NLP), etc. La connectivité récurrente permet aux informations de persister et d'être mises à jour à chaque itération ou pas de temps, ce qui les rend adaptés à des tâches séquentielles.
3.1 · Hyperparamètres
Où sont les hyperparamètres dans le code ?
À retenirTout ce qui est fixé avant l'entraînement est un hyperparamètre ; les poids, eux, sont appris.
notes
- Schéma : chaque hyperparamètre pointé dans un extrait Keras (forme d'entrée, nombre de neurones, activation, dropout, optimiseur, taux d'apprentissage, perte, époques, taille de lot).
3.1 · Hyperparamètres
Un hyperparamètre se fixe avant d'apprendre ; le taux d'apprentissage est le premier
Les hyperparamètres sont des paramètres constants dont la valeur est fixée avant le début du processus d'apprentissage. Contrairement aux paramètres du modèle, appris pendant l'entraînement, ce sont des choix de conception qui influencent la manière dont le modèle est formé.
Taux d'apprentissage
Il contrôle la taille des pas que l'algorithme d'optimisation prend pour ajuster les poids. Trop élevé : convergence rapide mais risque de sauter le minimum global ; trop bas : apprentissage lent ou coincé dans des minima locaux.
notes
- Les hyperparamètres sont des paramètres constants dont la valeur est fixée avant le début du processus d'apprentissage d'un réseau de neurones artificiels. Contrairement aux paramètres du modèle, qui sont appris pendant l'entraînement, les hyperparamètres sont des choix de conception qui influencent la manière dont le modèle est formé.
- Taux d'apprentissage : contrôle la taille des pas que l'algorithme d'optimisation prend pour ajuster les poids du modèle. Un taux trop élevé peut entraîner une convergence rapide mais sauter le minimum global ; un taux trop bas peut rendre l'apprentissage lent ou susceptible de rester coincé dans des minima locaux. (Courbes illustratives.)
3.1 · Hyperparamètres
Couches, taille de lot, activation
Nombre de couches cachées
Un choix de conception important : il influe sur la capacité du modèle à apprendre des représentations complexes. Plus de couches cachées capturent des caractéristiques plus abstraites, mais augmentent la complexité et le risque de surapprentissage.
Taille des échantillons
Le nombre d'exemples d'entraînement utilisés pour mettre à jour les poids à chaque itération. Un choix judicieux influence l'efficacité de l'entraînement et la stabilité du modèle.
Fonction d'activation
Elle introduit de la non-linéarité dans le modèle. Le choix de la fonction peut affecter la capacité du modèle à apprendre des relations complexes.
notes
- Nombre de couches cachées : choix de conception important ; influe sur la capacité à apprendre des représentations complexes ; plus de couches capturent des caractéristiques plus abstraites mais augmentent la complexité et le surapprentissage. Taille des échantillons (batch size) : nombre d'exemples utilisés pour mettre à jour les poids à chaque itération ; influence l'efficacité de l'entraînement et la stabilité. Fonction d'activation : introduit de la non-linéarité ; choix courants ReLU, Sigmoid, Tanh.
3.1 · Hyperparamètres
Régularisation, largeur, optimiseur
Régularisation
Les techniques de régularisation, telles que la régularisation L1 ou L2, ajoutent des termes de pénalité aux poids du modèle pour prévenir le surapprentissage. Le choix et la force de la régularisation sont des hyperparamètres importants.
Nombre de neurones par couche
En particulier dans les couches cachées, il influence la capacité du modèle à apprendre des représentations spécifiques. Un choix judicieux aide à contrôler la complexité du modèle.
Optimiseur
L'algorithme d'optimisation qui ajuste les poids du réseau lors de la rétropropagation.
notes
- Régularisation : L1 ou L2 ajoutent des termes de pénalité aux poids pour prévenir le surapprentissage ; le choix et la force sont des hyperparamètres importants. Nombre de neurones par couche : influence la capacité à apprendre des représentations spécifiques ; contrôle la complexité. Optimiseur : l'algorithme d'optimisation qui ajuste les poids lors de la rétropropagation ; exemples SGD, Adam, RMSprop.
3.1 · Hyperparamètres
Initialisation, perte, dropout, époques, momentum
Initialisation des poids
Méthode utilisée pour initialiser les poids du réseau avant l'entraînement.
Fonction de perte
Mesure la différence entre les prédictions du modèle et les vraies valeurs ; elle guide l'ajustement des poids lors de l'entraînement.
Taux de dropout
La fraction de neurones désactivés aléatoirement à chaque étape d'entraînement. Régularisation qui empêche le réseau de trop dépendre de quelques neurones.
Nombre d'époques
Le nombre de fois que l'ensemble de données complet passe à travers le réseau. Trop peu : sous-apprentissage ; trop : surapprentissage — d'où l'arrêt anticipé.
Moments
Paramètre qui accélère l'optimisation en ajoutant une fraction de l'itération précédente au poids actuel lors de la mise à jour.
notes
- Initialisation des poids : méthode utilisée pour initialiser les poids avant l'entraînement ; initialisation aléatoire, Xavier/Glorot. Fonction de perte : mesure la différence entre les prédictions et les vraies valeurs ; guide l'ajustement des poids. Taux de dropout : fraction de neurones désactivés aléatoirement à chaque étape (0.2 ou 0.5) ; régularisation qui limite le surapprentissage. Nombre d'époques : nombre de passages complets sur les données ; trop peu : sous-apprentissage ; trop : surapprentissage (d'où l'arrêt anticipé). Moments (momentum) : accélère l'optimisation en ajoutant une fraction de l'itération précédente à la mise à jour.
3.1 · Hyperparamètres · activations
ReLU pour les couches cachées, sigmoïde pour une sortie binaire
Largement utilisée en raison de sa simplicité et de sa capacité à introduire une non-linéarité. Elle remplace les valeurs négatives par zéro, permettant au réseau d'apprendre des représentations complexes.
Souvent utilisée en couche de sortie pour la classification binaire, car elle ramène les valeurs à l'intervalle [0, 1], interprétables comme des probabilités.
notes
- ReLU : largement utilisée en raison de sa simplicité et de sa capacité à introduire une non-linéarité ; elle remplace les valeurs négatives par zéro. f(x) = max(0, x). Sigmoid : souvent utilisée en couche de sortie pour les problèmes de classification binaire, car elle ramène les valeurs à l'intervalle [0, 1], pouvant être interprétées comme des probabilités. f(x) = 1/(1+e^{−x}).
3.1 · Hyperparamètres · activations
Tanh pour les couches cachées, softmax pour une sortie multiclasse
Similaire à la sigmoïde, mais ramène les valeurs à l'intervalle [−1, 1]. Souvent utilisée comme fonction d'activation pour les couches cachées.
Principalement utilisée en couche de sortie pour la classification multiclasse : elle transforme les scores en probabilités, pour chaque \(i\)-ème élément du vecteur \(x\).
notes
- Tanh : similaire à la fonction sigmoïde, mais ramène les valeurs à l'intervalle [−1, 1] ; souvent utilisée pour les couches cachées. f(x) = (e^{2x} − 1)/(e^{2x} + 1). Softmax : principalement utilisée en couche de sortie pour la classification multiclasse ; transforme les scores en probabilités. f(x)_i = e^{x_i} / Σ_j e^{x_j} pour chaque i-ème élément du vecteur x.
3.1 · Hyperparamètres · fonctions de perte
La fonction de perte dépend du problème : commencer par la régression
Les fonctions de perte (loss functions) mesurent à quel point les prédictions d'un modèle diffèrent des valeurs réelles attendues. Choisir la bonne fonction dépend du type de problème : classification, régression, ou autre.
| Fonction de perte | Type de problème | Utilisation |
|---|---|---|
| Mean Squared Error (MSE) | Régression | \( \frac{1}{n} \sum_{i=1}^{n} (y_i - \hat{y}_i)^2 \) — mesure l'erreur quadratique moyenne entre les prédictions \(\hat{y}_i\) et les valeurs réelles \(y_i\). Utile lorsque les erreurs doivent être pénalisées de manière significative. |
| Mean Absolute Error (MAE) | Régression | \( \frac{1}{n} \sum_{i=1}^{n} |y_i - \hat{y}_i| \) — mesure l'erreur absolue moyenne entre les prédictions et les valeurs réelles. Moins sensible aux valeurs aberrantes que le MSE. |
notes
- Les fonctions de perte (loss functions) sont des métriques qui mesurent à quel point les prédictions d'un modèle diffèrent des valeurs réelles attendues. Choisir la bonne fonction de perte dépend du type de problème que vous essayez de résoudre, qu'il s'agisse d'une tâche de classification, de régression, ou autre.
- MSE (régression) : (1/n) Σ (y_i − ŷ_i)² ; utile lorsque les erreurs doivent être pénalisées de manière significative. MAE (régression) : (1/n) Σ |y_i − ŷ_i| ; moins sensible aux valeurs aberrantes que le MSE.
3.1 · Hyperparamètres · fonctions de perte
Classification : l'entropie croisée, binaire ou catégorielle
| Fonction de perte | Type de problème | Utilisation |
|---|---|---|
| Binary Crossentropy | Classification binaire | \( -\frac{1}{n} \sum_{i=1}^{n} \left(y_i \cdot \log(\hat{y}_i) + (1-y_i) \cdot \log(1-\hat{y}_i)\right) \) — fonction de perte pour la classification binaire. Convient lorsque chaque exemple appartient à une seule classe. |
| Categorical Crossentropy | Classification multiclasse | \( -\frac{1}{n} \sum_{i=1}^{n} \sum_{j=1}^{m} y_{i,j} \cdot \log(\hat{y}_{i,j}) \) — convient lorsque chaque exemple appartient à une seule classe parmi plusieurs (étiquettes one-hot). Pour la classification multi-étiquettes, utiliser Binary Crossentropy sur chaque sortie. |
RepèreC'est la perte utilisée dans l'exemple Iris : trois classes, étiquettes one-hot.
notes
- Binary Crossentropy (classification binaire) : −(1/n) Σ (y_i·log(ŷ_i) + (1−y_i)·log(1−ŷ_i)) ; convient lorsque chaque exemple d'entraînement appartient à une seule classe. Categorical Crossentropy (classification multiclasse) : −(1/n) Σ_i Σ_j y_{i,j}·log(ŷ_{i,j}) ; convient lorsque chaque exemple appartient à une seule classe parmi plusieurs (étiquettes one-hot) ; pour la classification multi-étiquettes, utiliser Binary Crossentropy sur chaque sortie.
3.1 · Hyperparamètres · fonctions de perte
Hinge, Huber, Poisson : trois pertes pour des cas particuliers
| Fonction de perte | Type de problème | Utilisation |
|---|---|---|
| Hinge Loss | SVM (Support Vector Machine) | \( \frac{1}{n} \sum_{i=1}^{n} \max(0, 1 - y_i \cdot \hat{y}_i) \) — utilisée pour les machines à vecteurs de support. Pénalise les erreurs lorsque la prédiction \(\hat{y}_i\) n'est pas du bon côté de la marge. |
| Huber Loss | Régression | \( \frac{1}{n} \sum_{i=1}^{n} L_{\delta}(y_i - \hat{y}_i) \) — une combinaison de MSE et MAE. Moins sensible aux valeurs aberrantes que MSE et moins impactée par celles-ci que MAE. |
| Poisson Loss | Régression (Poisson) | \( \frac{1}{n} \sum_{i=1}^{n} \left(\hat{y}_i - y_i \cdot \log(\hat{y}_i) \right) \) — pour des tâches de régression où les valeurs suivent une distribution de Poisson. |
notes
- Hinge Loss (SVM) : (1/n) Σ max(0, 1 − y_i·ŷ_i) ; pénalise les erreurs lorsque la prédiction n'est pas du bon côté de la marge. Huber Loss (régression) : (1/n) Σ L_δ(y_i − ŷ_i) ; combinaison de MSE et MAE, moins sensible aux valeurs aberrantes. Poisson Loss (régression Poisson) : (1/n) Σ (ŷ_i − y_i·log(ŷ_i)) ; pour des valeurs qui suivent une distribution de Poisson.
3.1 · Hyperparamètres · optimiseurs
Trois optimiseurs : SGD, Adam, RMSprop
| Optimiseur | Description |
|---|---|
| Stochastic Gradient Descent (SGD) | L'optimiseur de descente de gradient stochastique classique. Il met à jour les poids du modèle en se déplaçant dans la direction opposée du gradient moyen calculé sur un petit lot de données d'entraînement à la fois. |
| Adam (Adaptive Moment Estimation) | Un optimiseur qui combine des idées de RMSprop et de Momentum. Il adapte les taux d'apprentissage des paramètres en fonction de leurs gradients moyens et de leurs moments moyens. Très populaire et souvent recommandé pour de nombreuses tâches. |
| RMSprop (Root Mean Square Propagation) | Ajuste les taux d'apprentissage pour chaque paramètre individuellement en utilisant une moyenne pondérée exponentielle des carrés des gradients. Cela aide à atténuer les problèmes liés aux taux d'apprentissage dans la descente de gradient stochastique. |
À retenirAdam est le choix par défaut ; le taux d'apprentissage reste l'hyperparamètre qui compte le plus.
notes
- SGD : descente de gradient stochastique classique ; met à jour les poids dans la direction opposée du gradient moyen calculé sur un petit lot. Adam : combine RMSprop et Momentum ; adapte les taux d'apprentissage des paramètres selon leurs gradients moyens et leurs moments moyens ; très populaire. RMSprop : ajuste les taux d'apprentissage pour chaque paramètre avec une moyenne pondérée exponentielle des carrés des gradients. Adam est le choix par défaut ; le taux d'apprentissage reste l'hyperparamètre qui compte le plus.
3.1 · Réseaux de neurones profonds
Un DNN : plusieurs couches de traitement, généralement plus de deux
Un réseau de neurones profond (DNN, Deep Neural Network), également appelé réseau de neurones profondément hiérarchisé, est un type de réseau de neurones artificiels qui comprend plusieurs couches de traitement, généralement plus de deux. Ces réseaux sont dits « profonds » en raison de leur architecture empilée de couches, permettant la création de représentations hiérarchiques complexes des données.
Couche d'entrée
Reçoit les données brutes ou caractéristiques en entrée.
Couches cachées
Effectuent des transformations non linéaires et apprennent des représentations hiérarchiques des données.
Couche de sortie
Produit la sortie du réseau, adaptée à la tâche spécifique : classification, régression, etc.
notes
- Un réseau de neurones profond, également connu sous le nom de réseau de neurones profondément hiérarchisé ou réseau neuronal profond (DNN), est un type de réseau de neurones artificiels qui comprend plusieurs couches de traitement, généralement plus de deux. Ces réseaux sont appelés « profonds » en raison de leur architecture empilée de couches, permettant la création de représentations hiérarchiques complexes des données. Architecture en couches : couche d'entrée (reçoit les données brutes ou caractéristiques), couches cachées (transformations non linéaires, représentations hiérarchiques), couche de sortie (sortie adaptée à la tâche : classification, régression, etc.).
3.1 · Réseaux de neurones profonds
Hiérarchie, non-linéarité, ajustement global : ce qui fait un réseau profond
Apprentissage hiérarchique
Les couches cachées apprennent des caractéristiques de plus en plus abstraites à mesure que l'on progresse en profondeur ; chaque couche est une abstraction des caractéristiques extraites par les précédentes.
Fonctions d'activation
Des fonctions non linéaires, telles que ReLU ou ses variantes, sont couramment utilisées dans les couches cachées pour apprendre des relations non linéaires.
Apprentissage profond
L'ajustement simultané des poids de toutes les couches pour minimiser l'erreur de prédiction, généralement par rétropropagation et descente de gradient.
Utilisations
Vision par ordinateur, reconnaissance vocale, traitement du langage naturel, traduction automatique, recommandation de contenu, et bien d'autres.
CoûtL'entraînement de réseaux profonds peut nécessiter des volumes importants de données et de puissance de calcul.
notes
- Apprentissage hiérarchique : les couches cachées apprennent des caractéristiques de plus en plus abstraites et complexes ; chaque couche représente une abstraction des caractéristiques extraites par les couches précédentes. Fonctions d'activation : non linéaires (ReLU ou ses variantes) dans les couches cachées. Apprentissage profond : ajustement simultané des poids de toutes les couches pour minimiser l'erreur, par rétropropagation et descente de gradient. Utilisations : vision par ordinateur, reconnaissance vocale, NLP, traduction automatique, recommandation ; des avancées significatives dans de nombreux domaines de l'IA. L'entraînement peut nécessiter des volumes importants de données et de puissance de calcul.
3.1 · Réseaux de neurones profonds · types
CNN pour les images, RNN pour les séquences
Il existe plusieurs types de réseaux de neurones profonds.
Réseaux de neurones convolutionnels (CNN)
Utilisation principale : vision par ordinateur, reconnaissance d'images.
Les CNN sont efficaces pour extraire des motifs spatiaux à partir d'images en utilisant des opérations de convolution. Ils sont largement utilisés pour la classification d'images, la détection d'objets et la segmentation d'images.
Réseaux de neurones récurrents (RNN)
Utilisation principale : traitement de séquences, traitement du langage naturel.
Les RNN sont conçus pour traiter des données séquentielles en utilisant des connexions récurrentes qui leur permettent de conserver une mémoire à long terme. Traduction automatique, génération de texte, analyse de séquences temporelles.
notes
- CNN — utilisation principale : vision par ordinateur, reconnaissance d'images ; caractéristiques : extraction de motifs spatiaux à partir d'images par convolution ; classification d'images, détection d'objets, segmentation. RNN — utilisation principale : traitement de séquences, NLP ; caractéristiques : connexions récurrentes qui conservent une mémoire à long terme ; traduction automatique, génération de texte, séquences temporelles.
3.1 · Réseaux de neurones profonds · types
GAN pour générer, ResNet pour aller très profond
Réseaux de neurones générateurs adverses (GAN)
Utilisation principale : génération d'images réalistes (approche dominante de 2014 à 2020).
Les GAN sont composés de deux réseaux, un générateur et un discriminateur, qui s'entraînent de manière adversaire. Pour la génération d'images, ils ont depuis été largement supplantés par les modèles de diffusion.
Réseaux de neurones résiduels (ResNet)
Utilisation principale : classification d'images profondes.
Les architectures ResNet utilisent des connexions résiduelles pour faciliter l'apprentissage profond en surmontant le problème du « vanishing gradient ». Fréquemment utilisés dans des compétitions de classification d'images.
notes
- GAN — utilisation principale : génération d'images réalistes (approche dominante de 2014 à 2020) ; deux réseaux, un générateur et un discriminateur, entraînés de manière adversaire ; largement supplantés par les modèles de diffusion pour la génération d'images. ResNet — classification d'images profondes ; connexions résiduelles pour surmonter le « vanishing gradient » ; compétitions de classification d'images.
3.1 · Réseaux de neurones profonds · types
Autoencodeurs pour compresser, LSTM pour les longues séquences
Autoencodeurs et Variational Autoencoders (VAE)
Utilisation principale : compression et génération de données.
Les autoencodeurs apprennent des représentations compactes en comprimant et en reconstruisant les informations. Les VAE introduisent des composants probabilistes, permettant de générer de nouvelles données similaires aux données d'entraînement.
Réseaux de mémoire à long terme (LSTM)
Utilisation principale : traitement du langage naturel, séquences temporelles.
Une variation des RNN qui intègre des mécanismes de portes pour mieux gérer le problème du gradient qui s'estompe sur de longues séquences. Génération de texte et autres tâches basées sur des séquences.
notes
- Autoencodeurs et VAE — compression et génération de données ; représentations compactes par compression et reconstruction ; les VAE ajoutent des composants probabilistes pour générer de nouvelles données. LSTM — NLP, séquences temporelles ; variation des RNN avec des mécanismes de portes contre le gradient qui s'estompe sur de longues séquences ; génération de texte.
3.1 · Réseaux de neurones profonds · types
Transformers et diffusion : les architectures dominantes depuis 2018
Transformers
Utilisation principale : traitement du langage naturel (grands modèles de langage : BERT, GPT, Llama…), et de plus en plus vision (ViT), audio et données multimodales.
Ils remplacent la récurrence par le mécanisme d'attention [Vaswani 2017] : chaque élément d'une séquence est mis en relation avec tous les autres en une seule étape, parallélisable sur GPU. Architecture dominante depuis 2018 (voir 4.7).
Modèles de diffusion
Utilisation principale : génération d'images, de vidéos et de sons (Stable Diffusion, DALL·E, Sora).
Ils apprennent à débruiter progressivement un signal aléatoire jusqu'à obtenir un échantillon réaliste [Ho 2020]. Entraînement plus stable que les GAN, qu'ils ont remplacés pour la génération d'images.
À retenirCNN pour les images, Transformers pour le texte (et de plus en plus tout le reste), diffusion pour générer.
notes
- Transformers — NLP (grands modèles de langage : BERT, GPT, Llama…), vision (ViT), audio, multimodal ; remplacent la récurrence par l'attention [Vaswani 2017] : chaque élément d'une séquence est mis en relation avec tous les autres en une seule étape, parallélisable sur GPU ; dominante depuis 2018 (voir 4.7). Modèles de diffusion — génération d'images, vidéos, sons (Stable Diffusion, DALL·E, Sora) ; débruitage progressif d'un signal aléatoire [Ho 2020] ; entraînement plus stable que les GAN.
3.2 · Feedforward neural network
Un réseau en aval : aucune boucle, de l'entrée vers la sortie
Les réseaux de neurones en aval, également appelés réseaux de neurones à propagation avant (Feedforward Neural Networks), se caractérisent par une architecture où les connexions entre les nœuds ne forment pas de cycles. L'information se déplace de manière unidirectionnelle, des nœuds d'entrée vers les nœuds de sortie, sans boucles récurrentes.
notes
- Les réseaux de neurones en aval (feedforward neural networks) se caractérisent par une architecture où les connexions entre les nœuds ne forment pas de cycles. L'information se déplace de manière unidirectionnelle, des nœuds d'entrée vers les nœuds de sortie, sans boucles récurrentes. (Figure Feed_forward_neural_net.gif du cours original, redessinée.)
3.2 · Feedforward neural network
Pas de cycle, un seul sens, une propagation avant
Pas de connexions cycliques
Contrairement aux réseaux récurrents, les réseaux en aval n'ont pas de connexions cycliques : pas de boucles entre les couches, l'information circule dans une seule direction.
Déplacement de l'information
L'information se déplace des nœuds d'entrée vers les nœuds de sortie en passant éventuellement par des nœuds cachés. Chaque couche traite les données indépendamment et transmet les résultats à la suivante.
Propagation avant
Le processus par lequel les données sont transmises à travers le réseau, couche par couche, jusqu'à la couche de sortie. Chaque connexion a un poids associé, ajusté pendant l'apprentissage.
notes
- Pas de connexions cycliques : pas de boucles ou de connexions récurrentes entre les couches ; l'information circule dans une seule direction. Déplacement de l'information : des nœuds d'entrée vers les nœuds de sortie en passant éventuellement par des nœuds cachés ; chaque couche traite les données indépendamment. Propagation avant : les données sont transmises couche par couche jusqu'à la sortie ; chaque connexion a un poids ajusté pendant l'apprentissage.
3.2 · Feedforward neural network
Apprentissage par rétropropagation, usages courants
Apprentissage par rétropropagation
Après la propagation avant, l'erreur entre la sortie prédite et la sortie réelle est calculée, puis rétropropagée à travers le réseau pour ajuster les poids et minimiser l'erreur.
Utilisation courante
Classification, régression, et autres problèmes où chaque exemple de données peut être traité indépendamment des autres.
Exemples d'application
Vision par ordinateur, traitement du langage naturel, reconnaissance vocale, etc.
notes
- Apprentissage par rétropropagation : après la propagation avant, l'erreur entre la sortie prédite et la sortie réelle est calculée, puis rétropropagée pour ajuster les poids et minimiser l'erreur. Utilisation courante : classification, régression, problèmes où chaque exemple peut être traité indépendamment. Exemples d'application : vision par ordinateur, NLP, reconnaissance vocale.
3.2 · Rétropropagation du gradient
La rétropropagation répartit l'erreur sur les connexions
La rétropropagation du gradient (backpropagation) est une technique clé de l'apprentissage des réseaux de neurones : elle ajuste les poids des connexions afin de minimiser l'erreur globale du modèle.
Ajustement des poids pour compenser l'erreur
La rétropropagation ajuste les poids des connexions du réseau pour compenser chaque erreur constatée lors de l'apprentissage. L'objectif est de minimiser la différence entre les prédictions du modèle et les valeurs réelles de sortie.
Répartition de l'erreur entre les connexions
Le montant de l'erreur est réparti entre les connexions du réseau : chaque poids contribue proportionnellement à l'erreur totale, et l'ajustement des poids est effectué en fonction de cette contribution.
notes
- La rétropropagation du gradient, également appelée backpropagation, est une technique clé utilisée dans l'apprentissage des réseaux de neurones pour ajuster les poids des connexions afin de minimiser l'erreur globale du modèle. Ajustement des poids pour compenser l'erreur : minimiser la différence entre les prédictions et les valeurs réelles. Répartition de l'erreur entre les connexions : chaque poids contribue proportionnellement à l'erreur totale, et l'ajustement est effectué en fonction de cette contribution.
3.2 · Rétropropagation du gradient
Gradient, règle de la chaîne, optimisation
Calcul du gradient de la fonction de perte
La rétropropagation calcule le gradient de la fonction de perte par rapport aux poids du réseau pour un seul exemple d'entrée-sortie. Le gradient représente la pente de la fonction de perte par rapport à chaque poids.
Règle de la chaîne
Elle décompose la dérivée d'une fonction composée en une série de dérivées partielles : calculer le gradient de la perte par rapport à chaque poids en remontant à travers le réseau.
Optimisation des poids
Une fois les gradients calculés, un algorithme d'optimisation, tel que la descente de gradient, ajuste les poids dans la direction qui minimise la fonction de perte.
À retenirUn processus itératif, sur plusieurs cycles (itérations ou époques), qui contribue à l'apprentissage des représentations et à l'amélioration des performances.
notes
- Calcul du gradient de la fonction de perte : par rapport aux poids du réseau pour un seul exemple d'entrée-sortie ; le gradient représente la pente de la perte par rapport à chaque poids. Règle de la chaîne : décomposer la dérivée d'une fonction composée en une série de dérivées partielles ; calculer le gradient par rapport à chaque poids en remontant à travers le réseau. Optimisation des poids : un algorithme d'optimisation, tel que la descente de gradient, ajuste les poids dans la direction qui minimise la perte. La rétropropagation est un processus itératif sur plusieurs cycles (itérations ou époques) d'entraînement.
3.2 · Rétropropagation du gradient · notations
Les notations : perte, poids, activations
La rétropropagation implique le calcul des gradients de la fonction de perte par rapport aux poids du réseau.
notes
- La rétropropagation du gradient implique le calcul des gradients de la fonction de perte par rapport aux poids du réseau. Notations : L la fonction de perte ; w_{ij}^{(k)} le poids entre le neurone i dans la couche k−1 et le neurone j dans la couche k ; a_i^{(k)} l'activation du neurone i dans la couche k. Calcul de l'erreur : y la sortie attendue et ŷ la sortie prédite ; l'erreur pour un exemple donné est mesurée par une fonction de perte L = fonction_de_perte(y, ŷ).
3.2 · Rétropropagation du gradient · équations
De la sortie vers l'entrée : le delta de chaque couche
notes
- Calcul du gradient de la fonction de perte par rapport à la sortie : ∂L/∂ŷ. Propagation arrière — règle de la chaîne : pour chaque couche k en partant de la sortie jusqu'à l'entrée, δ_i^{(k)} = ∂L/∂a_i^{(k)} et ∂L/∂w_{ij}^{(k)} = a_j^{(k−1)} · δ_i^{(k)}.
3.2 · Rétropropagation du gradient · équations
La mise à jour : un pas de taille η contre le gradient
Ces calculs sont effectués pour chaque exemple d'entraînement dans un lot (batch), et l'algorithme d'optimisation ajuste les poids pour minimiser la fonction de perte sur l'ensemble des données d'entraînement. Le processus est répété sur plusieurs époques jusqu'à ce que le modèle atteigne une performance souhaitée.
À retenirLa rétropropagation n'est que la règle de la chaîne appliquée couche par couche, de la sortie vers l'entrée.
notes
- Mise à jour des poids avec un algorithme d'optimisation (e.g., descente de gradient) : w_{ij}^{(k)} = w_{ij}^{(k)} − η · ∂L/∂w_{ij}^{(k)}, η est le taux d'apprentissage. Ces calculs sont effectués pour chaque exemple d'entraînement dans un lot (batch), et l'algorithme d'optimisation ajuste les poids pour minimiser la fonction de perte sur l'ensemble des données. Le processus est répété sur plusieurs époques jusqu'à ce que le modèle atteigne une performance souhaitée.
3.3 · Réseaux de neurones récurrents
Un RNN : la sortie à l'instant t dépend de ce qu'il a vu avant
Connexions temporelles
Chaque nœud combine l'entrée actuelle et l'état interne provenant de l'instant précédent. Les connexions forment un graphe dirigé qui suit la séquence temporelle, ce qui donne au réseau un comportement dynamique.
État interne
Il permet de traiter des séquences de longueur variable en mémorisant ce qui compte des instants précédents. Les informations retenues influencent les prédictions actuelles : c'est ce qui distingue un RNN d'un réseau à propagation avant.
À retenirLe même neurone est appliqué à chaque pas de temps ; seul l'état caché \(h_t\) circule d'un pas au suivant.
notes
- Un réseau de neurones où les connexions forment un graphe dirigé le long d'une séquence : la sortie à l'instant t dépend de l'entrée courante et de ce que le réseau a vu avant. Connexions temporelles : chaque nœud combine l'entrée actuelle et l'état interne de l'instant précédent ; les connexions forment un graphe dirigé qui suit la séquence temporelle. État interne (mémoire) : traiter des séquences de longueur variable en mémorisant ce qui compte ; les informations retenues influencent les prédictions actuelles. Le même neurone est appliqué à chaque pas de temps ; seul l'état caché h_t circule d'un pas au suivant.
3.3 · Réseaux de neurones récurrents
Déroulé dans le temps : une cellule, un pas par colonne

notes
- Déroulement dans le temps et applications : écriture manuscrite (reconnaître une suite de caractères dans un tracé) ; reconnaissance vocale (traiter la séquence temporelle d'un signal audio) ; texte (prédire le mot suivant, traduire, classer une phrase) ; séries temporelles (prévoir une valeur future : capteurs, finance, météo).
3.3 · Réseaux de neurones récurrents
Le neurone récurrent : cinq ingrédients
Entrée courante
La donnée observée à l'instant \(t\) : un mot, un échantillon audio, une mesure.
État caché précédent
La mémoire du réseau, héritée de l'instant \(t-1\) : c'est lui qui transporte les informations passées jusqu'au pas courant.
Poids
Un poids par connexion : ils fixent l'importance relative de \(x_t\) et de \(h_{t-1}\).
Fonction d'activation
Non linéaire (tanh en général) : elle combine les entrées et produit la sortie. La non-linéarité permet d'apprendre des relations complexes dans les séquences.
État caché
La sortie à l'instant \(t\), qui devient la mémoire transmise à l'instant \(t+1\).
notes
- Entrée courante x_t : la donnée observée à l'instant t (une caractéristique d'une séquence à cet instant : un mot, un échantillon audio, une mesure). État caché précédent h_{t−1} : la mémoire du réseau, héritée de l'instant t−1 ; il transporte les informations passées. Poids w : un poids par connexion ; importance relative de x_t et de h_{t−1}. Fonction d'activation : non linéaire (tanh en général) ; permet d'apprendre des relations complexes dans les données séquentielles. État caché h_t : la sortie à l'instant t, mémoire transmise à l'instant t+1.
3.3 · Réseaux de neurones récurrents
La formule générale du RNN
À retenir\(w_{hx}\), \(w_{hh}\) et \(b_h\) sont les mêmes à chaque pas : un RNN n'a pas plus de paramètres qu'une seule cellule, quelle que soit la longueur de la séquence.
notes
- Formule générale — sortie à l'instant t : h_t = f(w_hx · x_t + w_hh · h_{t−1} + b_h). w_hx : poids de l'entrée courante ; w_hh : poids de l'état caché précédent (la récurrence) ; b_h : biais ; f : fonction d'activation, généralement tanh. w_hx, w_hh et b_h sont les mêmes à chaque pas de temps : un RNN n'a pas plus de paramètres qu'une seule cellule, quelle que soit la longueur de la séquence.
3.3 · Réseaux de neurones récurrents
Quatre avantages des RNN
Traitement séquentiel
Conçus pour les données ordonnées : parole, traduction, prédiction temporelle.
Dépendances temporelles
La mémoire interne modélise le contexte des instants précédents. Adaptés aux problèmes où comprendre le contexte temporel est essentiel.
Paramètres partagés
La même cellule sert à chaque pas de temps : peu de paramètres, réutilisables.
Longueur variable
Une séquence de 5 ou de 500 éléments passe dans le même réseau.
notes
- Avantages — Traitement séquentiel : conçus pour les données ordonnées (parole, traduction, prédiction temporelle). Dépendances temporelles : la mémoire interne modélise le contexte des instants précédents ; adaptés aux problèmes où comprendre le contexte temporel est essentiel. Paramètres partagés : la même cellule sert à chaque pas de temps. Longueur variable : une séquence de 5 ou de 500 éléments passe dans le même réseau.
3.3 · Réseaux de neurones récurrents
Quatre limites — et deux réponses
Gradient qui disparaît ou explose
Sur de longues séquences, le gradient rétropropagé s'annule ou diverge : l'apprentissage devient difficile.
Dépendances très longues
En pratique, la mémoire s'estompe au bout de quelques dizaines de pas.
Calcul séquentiel
Impossible de paralléliser sur la longueur de la séquence. C'est cette limite qui a motivé le Transformer (attention, calcul parallèle), dominant pour le texte (voir 4.7).
Sensibilité à l'ordre
Une permutation des éléments change le résultat.
Deux réponsesLes LSTM / GRU (portes) pour le gradient ; le Transformer (attention, voir 4.7) pour le calcul parallèle.
notes
- Limites — Gradient qui disparaît ou explose : sur de longues séquences, le gradient rétropropagé s'annule ou diverge. Dépendances très longues : la mémoire s'estompe au bout de quelques dizaines de pas. Calcul séquentiel : le pas t attend le pas t−1 ; impossible de paralléliser sur la longueur de la séquence ; c'est cette limite qui a motivé l'architecture Transformer (attention, calcul parallèle sur toute la séquence), aujourd'hui dominante pour le texte (voir 4.7). Sensibilité à l'ordre : une permutation des éléments change le résultat. Deux réponses : les LSTM / GRU (portes) pour le gradient ; le Transformer (attention) pour le calcul parallèle.
3.3 · LSTM · [Hochreiter 1997]
Le LSTM ajoute une seconde mémoire, protégée par des portes
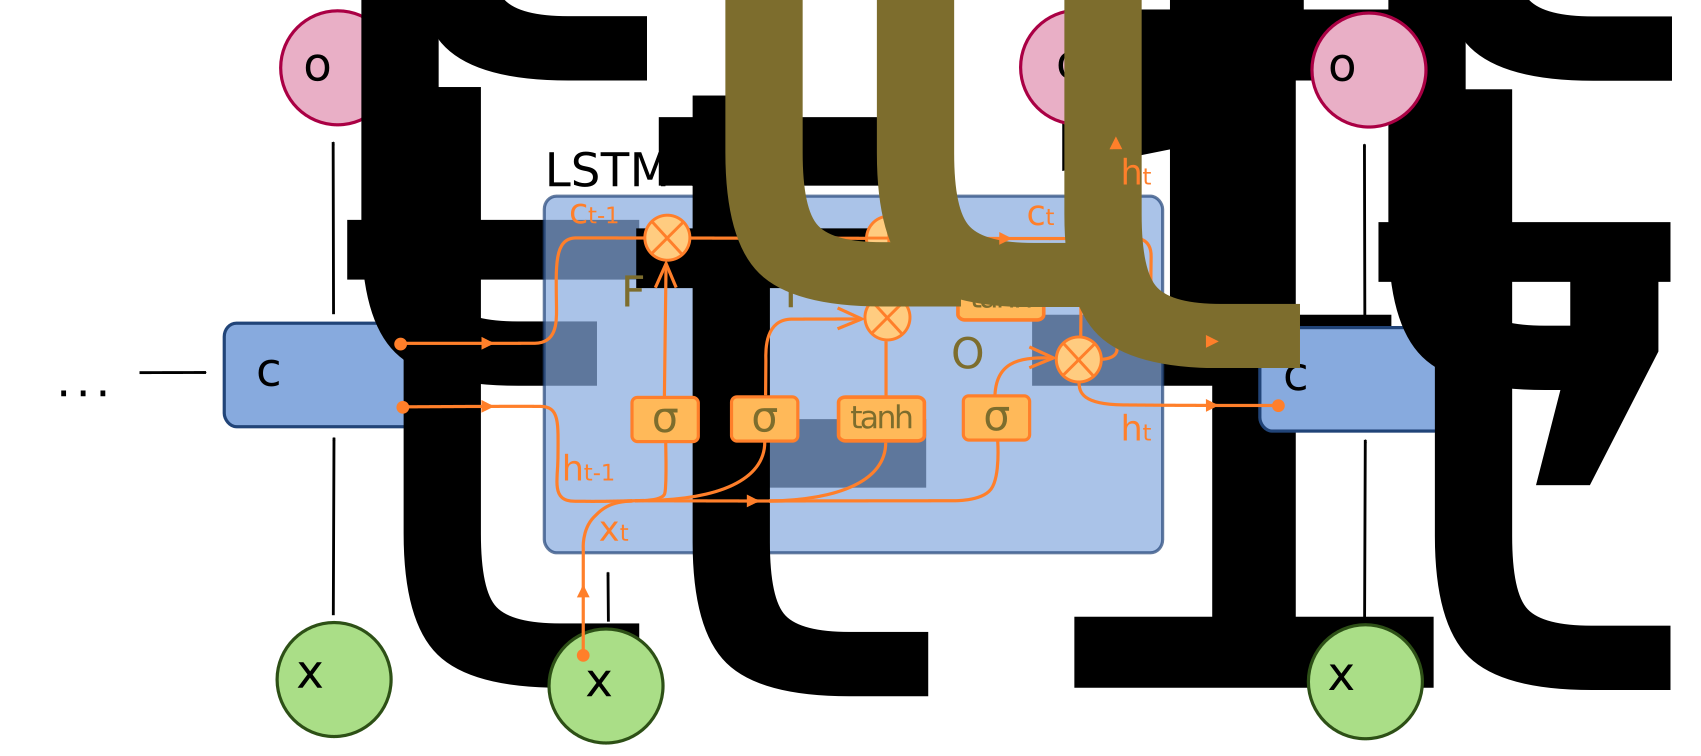
Une cellule récurrente à portes
Une cellule récurrente conçue pour résoudre le problème du gradient qui disparaît : un état de cellule \(c_t\) traverse le temps presque sans transformation, et trois portes décident ce qu'on y écrit, ce qu'on y oublie et ce qu'on en lit.
Le RNN simple a une seule mémoire \(h_t\) réécrite à chaque pas ; le LSTM en ajoute une seconde, \(c_t\), protégée par des portes.
notes
- Long short-term memory (LSTM) [Hochreiter 1997] : une cellule récurrente conçue pour résoudre le problème du gradient qui disparaît ; un état de cellule c_t traverse le temps presque sans transformation, et trois portes décident ce qu'on y écrit, ce qu'on y oublie et ce qu'on en lit. Le RNN simple a une seule mémoire h_t réécrite à chaque pas ; le LSTM en ajoute une seconde, c_t, protégée par des portes.
3.3 · LSTM · composants
Une cellule et trois portes
Cellule
La mémoire à long terme : elle stocke et régule l'information sur des intervalles de temps arbitraires. Elle peut être écrite, lue et modifiée.
Porte d'oubli
Décide quelles parties de l'information existante dans la cellule doivent être effacées.
Porte d'entrée
Décide quels éléments de la nouvelle information doivent être ajoutés à la cellule.
Porte de sortie
Décide quelle partie de la cellule est exposée en sortie, dans \(h_t\).
Ensemble, ces composants permettent à une unité LSTM de maintenir et de gérer des informations sur des périodes étendues ; les trois portes fournissent un mécanisme de régulation fin du flux d'information à travers la cellule.
À retenirChaque porte est une sigmoïde \(\sigma \in [0,1]\) : 0 = bloquer, 1 = laisser passer.
notes
- Cellule c_t : la mémoire à long terme ; stocke et régule l'information sur des intervalles de temps arbitraires ; écrite, lue et modifiée. Porte d'oubli f_t : quelles parties de l'information existante doivent être effacées. Porte d'entrée i_t : quels éléments de la nouvelle information doivent être ajoutés. Porte de sortie o_t : quelle partie de la cellule est exposée en sortie, dans h_t. Ensemble, ces composants permettent de maintenir et de gérer des informations sur des périodes étendues ; les trois portes régulent finement le flux d'information. Chaque porte est une sigmoïde σ ∈ [0,1] : 0 = bloquer, 1 = laisser passer.
3.3 · LSTM · équations
Les six équations du LSTM : oublier, écrire, lire
À l'instant \(t\) : entrée \(x_t\), sortie précédente \(h_{t-1}\), état de cellule précédent \(c_{t-1}\).
notes
- À l'instant t : entrée x_t, sortie précédente h_{t−1}, état de cellule précédent c_{t−1}. Porte d'oubli f_t = σ(W_f·x_t + U_f·h_{t−1} + b_f) ; porte d'entrée i_t = σ(W_i·x_t + U_i·h_{t−1} + b_i) ; candidat c̃_t = tanh(W_c·x_t + U_c·h_{t−1} + b_c) — nouvelle information proposée ; cellule c_t = f_t ⊙ c_{t−1} + i_t ⊙ c̃_t — oublier, puis écrire ; porte de sortie o_t = σ(W_o·x_t + U_o·h_{t−1} + b_o) ; sortie h_t = o_t ⊙ tanh(c_t) — lire.
3.3 · LSTM · lecture des équations
Pourquoi ça marche : le gradient traverse la cellule sans s'annuler
CoûtQuatre fois plus de paramètres qu'un RNN simple de même taille (quatre jeux \(W, U, b\)).
notes
- σ, tanh : sigmoïde (portes, dans [0,1]) et tangente hyperbolique (contenu, dans [−1,1]). W, U, b : poids de l'entrée, poids de la récurrence et biais, propres à chaque porte (indices f, i, c, o). ⊙ : produit élément par élément. Pourquoi ça marche : si f_t ≈ 1 et i_t ≈ 0, alors c_t ≈ c_{t−1} — le gradient traverse le temps sans s'annuler. Ces formules permettent aux LSTM de maintenir et de gérer l'information sur des intervalles de temps arbitraires, efficaces pour la modélisation de séquences complexes. Quatre fois plus de paramètres qu'un RNN simple de même taille.
3.3 · GRU · [Cho 2014]
Le GRU : deux portes au lieu de trois, pas d'état séparé
Une simplification du LSTM : deux portes au lieu de trois, pas d'état de cellule séparé (\(h_t\) joue les deux rôles). Moins de paramètres, entraînement plus rapide, performances souvent comparables.
À retenirQuand \(z_t \to 0\), l'état est simplement recopié : c'est ce qui conserve une information sur de longues séquences.
notes
- Gated Recurrent Unit (GRU) [Cho 2014] : une simplification du LSTM — deux portes au lieu de trois, pas d'état de cellule séparé (h_t joue les deux rôles) ; moins de paramètres, entraînement plus rapide, performances souvent comparables. Porte de mise à jour z_t = σ(W_z·x_t + U_z·h_{t−1} + b_z) — combien conserver ; porte de réinitialisation r_t = σ(W_r·x_t + U_r·h_{t−1} + b_r) — combien relire ; état candidat h̃_t = tanh(W_h·x_t + U_h·(r_t ⊙ h_{t−1}) + b_h) ; nouvel état h_t = (1 − z_t) ⊙ h_{t−1} + z_t ⊙ h̃_t. Quand z_t → 0, l'état est simplement recopié : c'est ce qui conserve une information sur de longues séquences.
3.4 · Réseaux de neurones convolutionnels
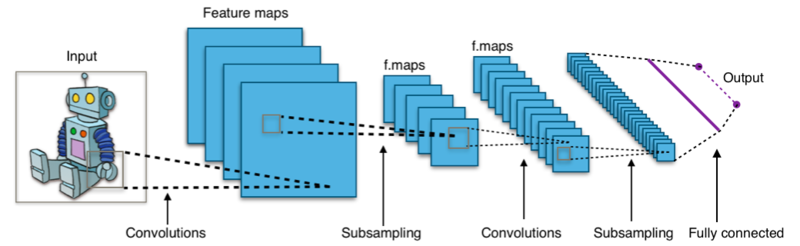
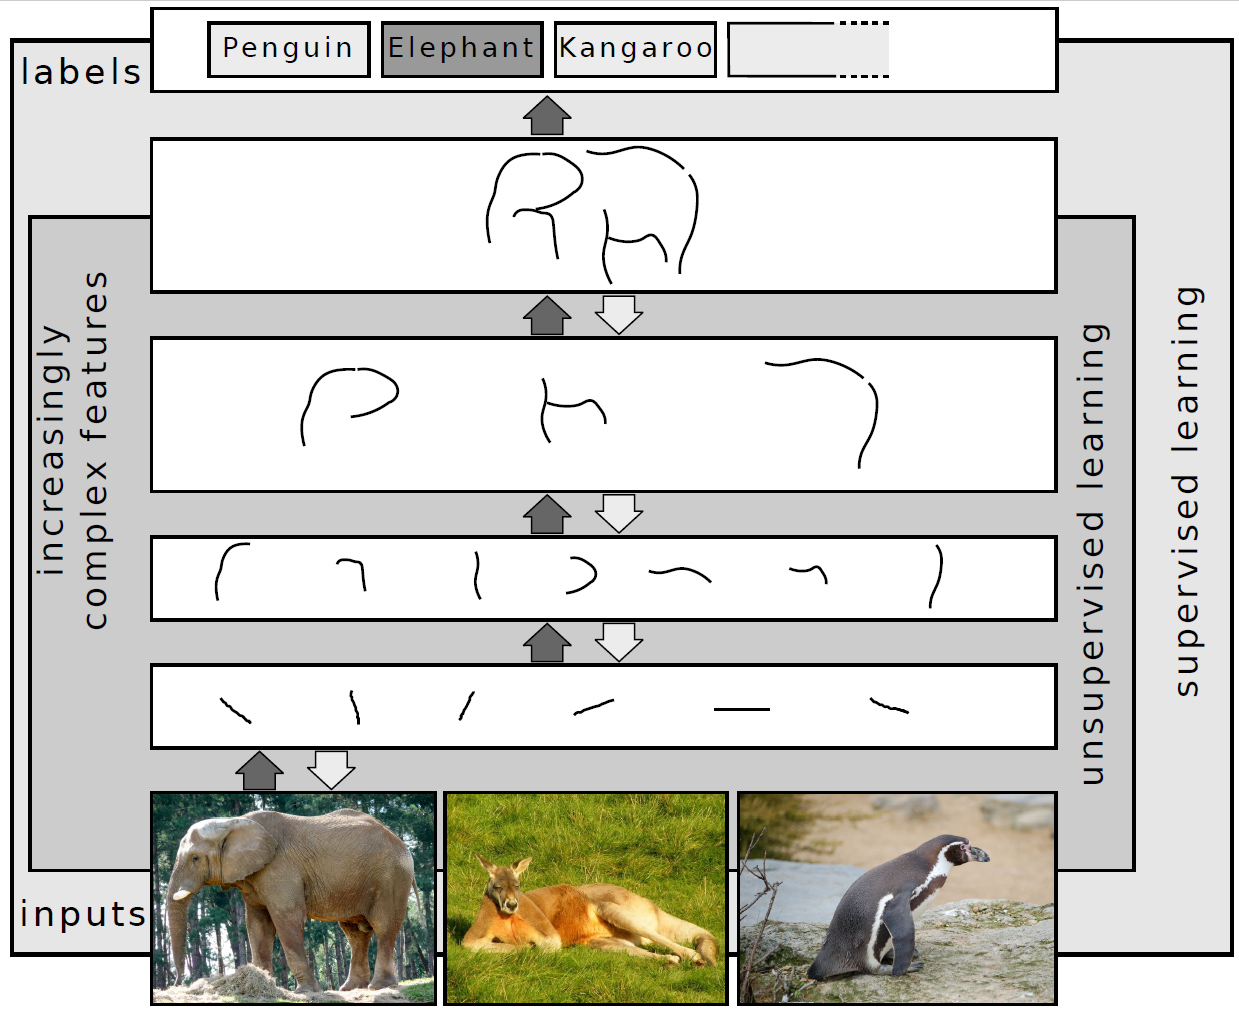
Un CNN vu de loin : convolutions, pooling, puis couches denses

notes
- Réseaux de neurones convolutionnels — figures Typical_cnn.png et Deep_Learning.jpg. Source : https://en.wikipedia.org/wiki/File:Deep_Learning.jpg
3.4 · Réseaux de neurones convolutionnels
L'architecture typique, en grand
notes
- Réseaux de neurones convolutionnels — figure Typical_cnn.png en pleine page.
3.4 · Réseaux de neurones convolutionnels
Les CNN sont faits pour les données en grille : les images
Les réseaux de neurones convolutionnels (CNN) sont une classe d'architectures de réseaux neuronaux conçues principalement pour l'analyse des images. Ils ont été particulièrement efficaces dans des tâches telles que la classification d'images, la détection d'objets, et la segmentation d'images.
Analyse des images
Les CNN sont spécifiquement conçus pour travailler avec des données structurées en grilles, comme les images. Ils sont capables de capturer des motifs et des caractéristiques spatiales importantes dans les images.
notes
- Les réseaux de neurones convolutionnels (CNN) sont une classe d'architectures de réseaux neuronaux conçues principalement pour l'analyse des images. Ils ont été particulièrement efficaces dans des tâches telles que la classification d'images, la détection d'objets, et la segmentation d'images. Analyse des images : conçus pour des données structurées en grilles, comme les images ; capables de capturer des motifs et des caractéristiques spatiales importantes.
3.4 · Réseaux de neurones convolutionnels
Une convolution extrait des caractéristiques locales ; les couches s'empilent
Utilise la convolution
La convolution est une opération mathématique linéaire utilisée pour extraire des caractéristiques locales à partir de l'image. Les filtres de convolution sont appliqués à l'image pour détecter des motifs tels que des bords, des textures, ou des formes.
Architecture en couches
Les CNN suivent une architecture en couches : une couche d'entrée pour recevoir l'image, une ou plusieurs couches cachées composées principalement de couches convolutives, et une couche de sortie pour produire les résultats finaux.
notes
- Utilise la convolution : opération mathématique linéaire pour extraire des caractéristiques locales de l'image ; les filtres de convolution détectent des motifs tels que des bords, des textures, ou des formes. Architecture en couches : une couche d'entrée pour recevoir l'image, une ou plusieurs couches cachées composées principalement de couches convolutives, et une couche de sortie.
3.4 · Réseaux de neurones convolutionnels
Couches convolutives et applications
Couches convolutives
Responsables de l'extraction des caractéristiques de l'image. Chaque couche peut avoir plusieurs filtres de convolution qui apprennent à détecter des motifs spécifiques. Ces couches sont souvent suivies de couches de pooling pour réduire la dimensionnalité tout en préservant les caractéristiques importantes.
Applications
Classification d'images (reconnaître des animaux dans des photos), détection d'objets (localiser et identifier des objets spécifiques), segmentation d'images (diviser une image en régions sémantiquement significatives).
notes
- Couches convolutives : extraction des caractéristiques de l'image ; chaque couche peut avoir plusieurs filtres qui apprennent à détecter des motifs spécifiques ; souvent suivies de couches de pooling pour réduire la dimensionnalité tout en préservant les caractéristiques importantes. Applications : classification d'images (reconnaître des animaux dans des photos), détection d'objets (localiser et identifier des objets spécifiques), segmentation d'images (diviser une image en régions sémantiquement significatives).
3.4 · Architecture
Un modèle hiérarchique : des motifs simples aux caractéristiques complexes
Modèle hiérarchique des données
Les CNN capturent des caractéristiques hiérarchiques : des motifs simples dans les premières couches, combinés en caractéristiques plus complexes dans les couches suivantes.
Architecture d'un CNN
Une couche d'entrée, plusieurs couches cachées et une couche de sortie. Les couches cachées sont principalement convolutionnelles, mais peuvent inclure des couches de regroupement (pooling), entièrement connectées, et de normalisation.
notes
- Modèle hiérarchique des données : les CNN capturent des caractéristiques hiérarchiques, en particulier pour l'analyse d'images : des motifs simples dans les premières couches, combinés pour former des caractéristiques plus complexes dans les couches suivantes. Architecture d'un CNN : une couche d'entrée, plusieurs couches cachées et une couche de sortie ; les couches cachées consistent principalement en couches convolutionnelles, mais peuvent inclure des couches de regroupement (pooling), des couches entièrement connectées, et des couches de normalisation.
3.4 · Architecture
Convolution + ReLU, puis pooling, dense et normalisation
Couches convolutionnelles et fonction d'activation
Les couches convolutionnelles appliquent des filtres pour extraire des caractéristiques ; la multiplication est effectuée par la convolution. L'activation la plus courante est ReLU, qui introduit une non-linéarité essentielle pour apprendre des relations complexes.
Couches supplémentaires
Après les convolutions : des couches de regroupement pour réduire la dimensionnalité, des couches entièrement connectées pour combiner des caractéristiques globales, et des couches de normalisation pour améliorer la stabilité de l'apprentissage.
En résumé, les CNN suivent une architecture hiérarchique : les couches convolutives apprennent des caractéristiques locales, combinées dans les couches suivantes en représentations plus complexes. La non-linéarité de ReLU est cruciale pour apprendre des relations non linéaires dans les données.
notes
- Couches convolutionnelles et fonction d'activation : les couches convolutionnelles appliquent des filtres pour extraire des caractéristiques de l'image ; la multiplication est effectuée par la convolution ; la fonction d'activation la plus courante est ReLU, qui introduit une non-linéarité importante pour apprendre des relations complexes. Couches supplémentaires : regroupement pour réduire la dimensionnalité, entièrement connectées pour combiner des caractéristiques globales, normalisation pour la stabilité. En résumé, les CNN suivent une architecture hiérarchique où les couches convolutives apprennent des caractéristiques locales, combinées dans les couches suivantes ; la non-linéarité de ReLU est cruciale.
3.4 · Noyau
Un noyau est une petite matrice que l'on fait glisser sur l'image
Noyau (traitement d'image)
Une petite matrice appliquée sur une image par une opération de convolution, pour réaliser diverses opérations de filtrage : détection de contours, amélioration des détails, mise en évidence de certaines caractéristiques, etc.
Convolution dans les CNN
Une opération clé : appliquer un ensemble de filtres (noyaux) à une image d'entrée. Chaque filtre est conçu pour extraire des caractéristiques spécifiques, comme des bords, des textures, ou d'autres motifs.
notes
- Un noyau dans le contexte du traitement d'images, également appelé filtre ou masque, est une petite matrice qui est appliquée sur une image à l'aide d'une opération de convolution. L'objectif est de réaliser diverses opérations de filtrage : détection de contours, amélioration des détails, mise en évidence de certaines caractéristiques, etc. Convolution dans les CNN : une opération clé qui consiste à appliquer un ensemble de filtres (noyaux) à une image d'entrée ; chaque filtre extrait des caractéristiques spécifiques (bords, textures, motifs).
3.4 · Noyau
Les noyaux ne sont pas dessinés à la main : ils sont appris
Apprentissage des noyaux
L'une des caractéristiques importantes des CNN est la capacité d'apprendre les filtres (noyaux) de manière automatique pendant l'entraînement.
Au lieu de définir manuellement les filtres comme dans le traitement d'images traditionnel, les CNN ajustent les poids des filtres pendant la phase d'apprentissage en fonction des caractéristiques qui sont importantes pour la tâche à accomplir.
| traitement d'image classique | noyau choisi par l'ingénieur |
| CNN | noyau appris par rétropropagation |
| Conv2D(32, (3, 3)) | 32 noyaux, 320 paramètres |
Le filtre de Sobel détecte des bords parce qu'on l'a écrit ainsi ; le filtre d'un CNN détecte ce qui sert à la tâche.
notes
- Apprentissage des noyaux : l'une des caractéristiques importantes des CNN est la capacité d'apprendre les filtres (noyaux) de manière automatique pendant l'entraînement. Au lieu de définir manuellement les filtres comme dans le traitement d'images traditionnel, les CNN ajustent les poids des filtres pendant la phase d'apprentissage en fonction des caractéristiques qui sont importantes pour la tâche à accomplir.
3.4 · Noyau
Des contours aux concepts, puis moins de pixels
- Premières couches
filtres simples : contours, textures de base
bords - Couches intermédiaires
filtres plus complexes, caractéristiques de niveau supérieur
motifs, parties - Sortie
caractéristiques abstraites de l'image d'entrée
objets
Rôle dans la hiérarchie des caractéristiques
Les premières couches d'un CNN apprennent généralement des filtres simples qui détectent des contours ou des textures de base. À mesure que l'on progresse, les filtres deviennent plus complexes, jusqu'à ce que la sortie finale représente des caractéristiques abstraites de l'image d'entrée.
Réduction de dimension avec le pooling
Après la convolution, les CNN utilisent souvent des couches de pooling pour réduire la dimension de la représentation, tout en préservant les caractéristiques importantes extraites par les filtres. Cela économise des ressources tout en maintenant les informations cruciales.
notes
- Rôle dans la hiérarchie des caractéristiques : les premières couches apprennent des filtres simples (contours, textures de base) ; en progressant dans les couches, les filtres deviennent plus complexes, capturant des caractéristiques de niveau supérieur, jusqu'à ce que la sortie finale représente des caractéristiques abstraites de l'image. Réduction de dimension avec le pooling : après la convolution, des couches de pooling réduisent la dimension de la représentation tout en préservant les caractéristiques importantes ; économie de ressources computationnelles.
3.4 · Convolution matricielle
La convolution, écrite comme une double somme
La convolution consiste à appliquer un noyau (filtre) sur une image en le déplaçant sur l'ensemble de l'image, en multipliant les valeurs des pixels correspondants, et en produisant une nouvelle image appelée carte de caractéristiques.
LectureChaque valeur de la carte est le produit scalaire du noyau avec la fenêtre de l'image qu'il recouvre.
notes
- La convolution est le processus central qui consiste à appliquer un noyau (aussi appelé filtre) sur une image. Cela se fait en déplaçant le noyau sur l'ensemble de l'image, multipliant les valeurs des pixels correspondants et produisant une nouvelle image appelée carte de caractéristiques. Formule matricielle : X ∗ Y = Σ_{i=0}^{m−1} Σ_{j=0}^{n−1} x_{(m−i)(n−j)} y_{(1+i)(1+j)}.
3.4 · Max pooling
Le max pooling garde la valeur la plus forte de chaque bloc
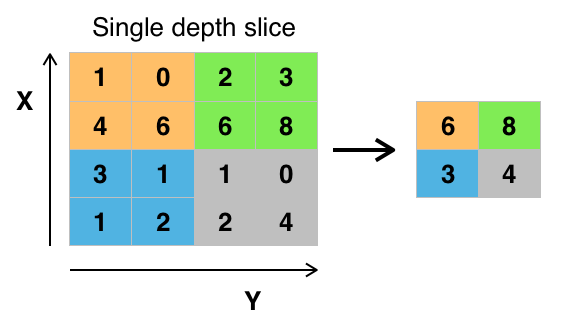

À retenirAprès la convolution, le pooling (max ou moyenne) réduit la dimension de la carte de caractéristiques en préservant les informations importantes.
notes
- Après la convolution, des opérations de pooling (souvent max pooling ou moyenne pooling) sont effectuées pour réduire la dimension de la carte de caractéristiques en préservant les informations importantes. Figure : max pooling avec un filtre 2 × 2 et un pas de 2. Source : https://commons.wikimedia.org/wiki/File:Max_pooling.png
3.4 · Stride et padding
Stride : de combien on avance ; padding : ce qu'on ajoute au bord
Stride
Contrôle le déplacement du noyau sur l'image. Un stride de 1 signifie un déplacement pixel par pixel, tandis qu'un stride plus grand réduit la taille de la carte de caractéristiques.
Padding
Ajoute des pixels autour de l'image d'entrée pour maintenir la taille de la sortie après la convolution.
| entrée 32×32, noyau 3×3, stride 1, sans padding | 30×30 |
| entrée 32×32, noyau 3×3, stride 1, padding 1 | 32×32 |
| entrée 32×32, noyau 3×3, stride 2, sans padding | 15×15 |
notes
- Stride : contrôle le déplacement du noyau sur l'image. Un stride de 1 signifie un déplacement pixel par pixel, tandis qu'un stride plus grand réduit la taille de la carte de caractéristiques. Padding : ajoute des pixels autour de l'image d'entrée pour maintenir la taille de la sortie après la convolution.
3.4 · Un CNN complet
Les formes à chaque couche : la largeur diminue, la profondeur augmente
À retenirLa largeur diminue (convolutions, pooling), la profondeur augmente (nombre de filtres) : le réseau échange la position contre le sens.
notes
- Pile de couches d'un CNN sur CIFAR-10 : entrée 32×32×3 → Conv 3×3 (32) 30×30×32 → MaxPool 15×15×32 → Conv 3×3 (64) 13×13×64 → MaxPool 6×6×64 → Conv 3×3 (64) 4×4×64 → Flatten 1024 → Dense 64 → Dense 10.
3.4 · Exemple · TensorFlow
Un CNN en Keras : trois blocs convolution + pooling
import tensorflow as tf
from tensorflow.keras import datasets, layers, models

(train_images, train_labels), (test_images, test_labels) = datasets.cifar10.load_data()
train_images, test_images = train_images / 255.0, test_images / 255.0

# Créer un modèle séquentiel (réseaux de neurones convolutionnels)
model = models.Sequential()
model.add(layers.Input(shape=(32, 32, 3)))
model.add(layers.Conv2D(32, (3, 3), activation='relu'))
model.add(layers.MaxPooling2D((2, 2)))
model.add(layers.Conv2D(64, (3, 3), activation='relu'))
model.add(layers.MaxPooling2D((2, 2)))
model.add(layers.Conv2D(64, (3, 3), activation='relu'))
| Input | 32×32×3 |
| Conv2D 32 | 30×30×32 |
| MaxPooling | 15×15×32 |
| Conv2D 64 | 13×13×64 |
| MaxPooling | 6×6×64 |
| Conv2D 64 | 4×4×64 |
CIFAR-10 : 60 000 images 32×32 en couleur, 10 classes ; les pixels sont ramenés dans [0, 1].
notes
import tensorflow as tf
from tensorflow.keras import datasets, layers, models
(train_images, train_labels), (test_images, test_labels) = datasets.cifar10.load_data()
train_images, test_images = train_images / 255.0, test_images / 255.0
# Créer un modèle séquentiel (réseaux de neurones convolutionnels)
model = models.Sequential()
model.add(layers.Input(shape=(32, 32, 3)))
model.add(layers.Conv2D(32, (3, 3), activation='relu'))
model.add(layers.MaxPooling2D((2, 2)))
model.add(layers.Conv2D(64, (3, 3), activation='relu'))
model.add(layers.MaxPooling2D((2, 2)))
model.add(layers.Conv2D(64, (3, 3), activation='relu'))
3.4 · Exemple · TensorFlow
Aplatir, classer, compiler, entraîner
model.add(layers.Flatten())
model.add(layers.Dense(64, activation='relu'))
model.add(layers.Dense(10))

# Compilation du modèle
model.compile(optimizer='adam',
              loss=tf.keras.losses.SparseCategoricalCrossentropy(from_logits=True),
              metrics=['accuracy'])

history = model.fit(train_images, train_labels, epochs=10,
                    validation_data=(test_images, test_labels))
| Flatten | 4×4×64 → 1024 |
| Dense 64 | relu |
| Dense 10 | un score par classe (logits) |
from_logits=True : la perte applique elle-même le softmax ; les étiquettes sont des entiers, d'où Sparse.
notes
model.add(layers.Flatten())
model.add(layers.Dense(64, activation='relu'))
model.add(layers.Dense(10))
#Compilation du modèle
model.compile(optimizer='adam',
              loss=tf.keras.losses.SparseCategoricalCrossentropy(from_logits=True),
              metrics=['accuracy'])
history = model.fit(train_images, train_labels, epochs=10,
                    validation_data=(test_images, test_labels))
3.4 · Exemple · TensorFlow
Le modèle du tutoriel TensorFlow, en image
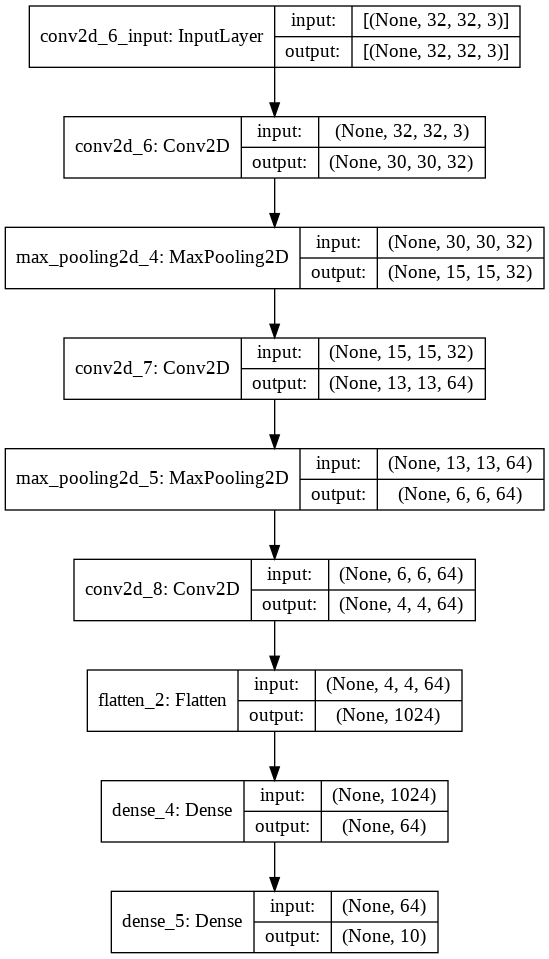
À retenirTrois blocs conv + pooling : ~70 % sur CIFAR-10 ; ResNet en empile des dizaines, reliés par des connexions résiduelles.
notes
- Modèle : https://www.tensorflow.org/tutorials/images/cnn. Trois blocs conv + pooling : ~70 % sur CIFAR-10 ; ResNet en empile des dizaines, reliés par des connexions résiduelles.
Références
Articles de recherche
- [Aly 2005] Aly, Mohamed. Survey on Multiclass Classification Methods. 2005.
- [Cho 2014] Cho, Kyunghyun, et al. « Learning Phrase Representations using RNN Encoder–Decoder for Statistical Machine Translation ». Proceedings of EMNLP 2014, p. 1724‑34. doi:10.3115/v1/D14-1179.
- [Hochreiter 1997] Hochreiter, Sepp, et Jürgen Schmidhuber. « Long Short-Term Memory ». Neural Computation, vol. 9, no 8, 1997, p. 1735‑80.
- [Ho 2020] Ho, Jonathan, Ajay Jain et Pieter Abbeel. « Denoising Diffusion Probabilistic Models ». Advances in Neural Information Processing Systems 33, 2020.
- [Jaakkola 2019] Jaakkola, H., et al. « Artificial Intelligence Yesterday, Today and Tomorrow. » 2019 42nd International Convention (MIPRO), 2019, pp. 860–67. IEEE Xplore.
- [Krizhevsky 2012] Krizhevsky A, Sutskever I, Hinton GE. « Imagenet classification with deep convolutional neural networks ». Advances in neural information processing systems, 2012, 25.
- [Pan 2016] Pan, Yunhe. « Heading toward Artificial Intelligence 2.0. » Engineering, vol. 2, no. 4, Dec. 2016, pp. 409–13.
- [Simonyan 2015] Simonyan K., Zisserman A. « Very Deep Convolutional Networks for Large-Scale Image Recognition ». International Conference on Learning Representations, 2015.
- [Vaswani 2017] Vaswani, Ashish, et al. « Attention Is All You Need ». Advances in Neural Information Processing Systems 30, 2017, p. 5998‑6008.
notes
- Références du cours original.
Références · Web
Sur le web
Wikipédia et scikit-learn
CréditsImages : Wikimedia Commons · Couleurs : Material Design Color Tool · Licence CC BY-SA 4.0.
notes
- Couleurs : Color Tool - Material Design. Images : Wikimedia Commons.